pretrain 和 scaling 作为一种方法论和科学观
GEN-1.5 的公开技术报告展示了一条持续八个多月的预训练损失曲线:在三个连续训练阶段中,验证集上的下一步动作预测误差呈现持续下降趋势。
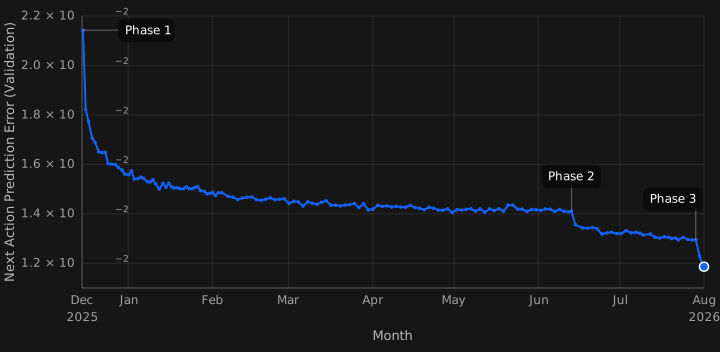
预训练与规模扩展(scaling)构成了从数据经验中提取通用计算能力的系统方法。数据提供经验,计算支持数值优化,训练将经验中的可迁移结构编码进模型参数。这一方法论在语言模型、世界模型与具身智能等不同领域具有相通的底层逻辑。
1. 通用框架与可扩展性
这种方法需要什么条件?杨植麟与张小珺的对谈中,提到了两点:[2]
- 具备足够通用的框架,能够容纳并利用多源异构的经验数据。
- 具备可扩展的学习过程,能够将新增的数据与计算预算持续转化为性能提升。
学习框架具体涵盖模型架构、数据表征、训练目标与优化算法。框架确立后,核心工程问题在于新增计算的收益、计算效率、数值稳定性与外推可预测性。
Dyna-2 将人类第一视角视频预训练数据扩展至一百万小时,在未标注的机器人数据上获得了预测精度的改善。在保持后训练设置一致的前提下,14 项实机评估任务的平均归一化得分随预训练数据量增加而提高,数据组成与视频预测目标亦对迁移效果产生明确影响。[3]
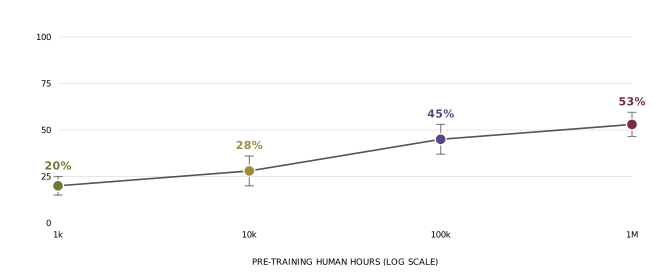
Dyna-2 表明了预训练表征向具体下游任务迁移的可行性。不同领域可以使用不同的模型架构、评价指标与规模曲线,但核心研究目标均在于确认哪些学习条件能够稳定支持这种跨任务迁移与持续性能提升。
2. 设计学习条件
深度学习早期的常见探索方式,是依据人类认知的直观划分(例如将长期记忆、短期记忆与工作记忆对应为不同计算模块)设计定制化的注意力结构。然而,认知层面的类比可以提供假设启发,但新增模块在大规模训练中的有效性仍需通过实证检验。靠实验结果说话!
模型设计的核心问题,在于确定能够让能力通过优化过程自然形成并随规模扩展保持改善的架构、数据与目标。新增的人工设计机制必须通过最终的学习效果、参数效率和可扩展性检验其必要性,奥卡姆剃刀原则——“如无必要,勿增实体”——在网络结构设计中同样适用。
Sutton 在 The Bitter Lesson 中指出,依赖通用计算并能随算力提升持续获益的方法,长期来看优于依赖人工先验结构的方法。从特征工程(feature engineering)转向特征学习(feature learning),本质是将具体表征的构建过程交由数值优化决定;预训练进一步将该思路推广至多任务与海量数据。[4]
Karpathy 在 Software 2.0 中阐述了对应的工程范式,即由研究者定义网络拓扑、构建数据集与设定损失函数,通过最优化算法在参数空间中搜索具体程序。对于能够精确判定输出质量、但难以人工穷举逻辑规则的任务,这种范式具有显著优势。[5]
形式简单的目标函数同样可以驱动复杂表征与高阶能力的建立。工程系统对有效能力的构建,可以先于对模型内部表征机制的完整理论解释。
3. Pretraining 与 scaling
Pretraining 与 scaling 涉及两个不同的问题维度。Pretraining 解决可复用能力的形成问题,通过在大规模无标注或弱标注数据上的训练,将通用的统计结构编码至权重中,赋予单一基座模型适应多类任务的基础;Scaling 则解决能力的连续提升问题,研究随着参数量、数据量和计算预算的增加,模型表现呈现的演化规律。
预训练的核心价值在于降低下游适应的学习成本。完成预训练的模型,既可以通过有监督微调(SFT)更新参数以适应新任务,也可以通过上下文学习(In-Context Learning, ICL)直接利用提示中的输入示范。GEN-1.5 演示了无须梯度更新的单次示范上下文学习,以及仅需少量梯度更新的任务适应。[1]
评估预训练质量的维度,不仅包含静态测试集上的绝对表现,也包含模型吸收新经验的效率,即适应新任务所需的示范数量、优化步数以及算力消耗。通过前置的大规模预训练,能够摊薄多个下游任务的学习成本。
Scaling 的研究范畴跨越整个生命周期。在训练阶段,增加预训练与强化学习的计算量能够改善基础表征;在推理阶段,通过思维链展开、搜索算法或环境交互分配计算量,同样能够提高输出质量。因此,算力分配的效益需要在训练时与推理时分别建模与评估。
4. 训练与推理的两个里程碑
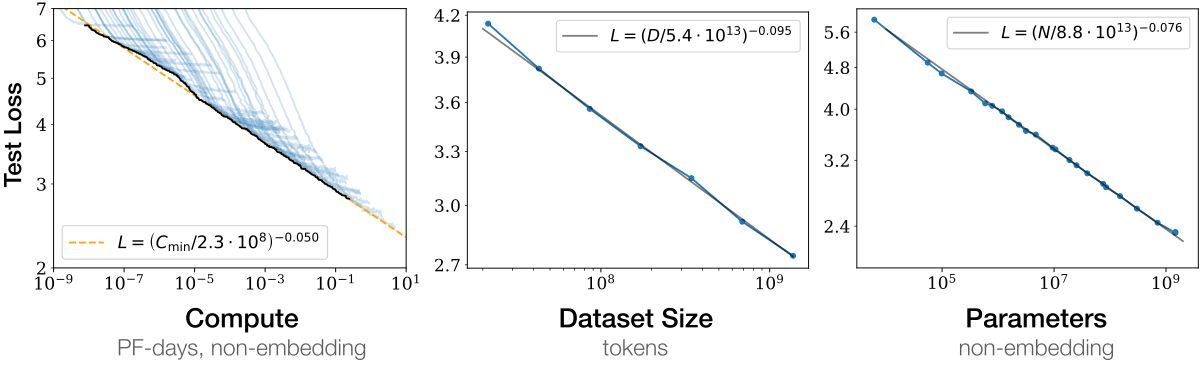
2020 年语言模型 scaling laws 的实证确认与 2024 年 o1 模型的发布,分别对应了模型在训练与推理两个阶段的计算扩展标志。
2020 年,OpenAI 系统研究了语言模型的 scaling laws,将模型参数量、训练数据量、计算预算与预训练交叉熵损失之间的关系量化为可测量的经验规律,为大规模训练提供了定量预测与资源规划基准。在此之前,Hestness 等人亦开展过早期的深度学习规模扩展实证研究。[6][7]
2024 年,o1 呈现了测试时计算扩展的重要进展:通过强化学习优化推理轨迹,模型能够有效利用更多推理阶段的计算预算。训练优化了模型展开中间思考步骤与策略搜索的效率,推理阶段则将额外算力直接转化为单次复杂任务的解题准确率。[8]
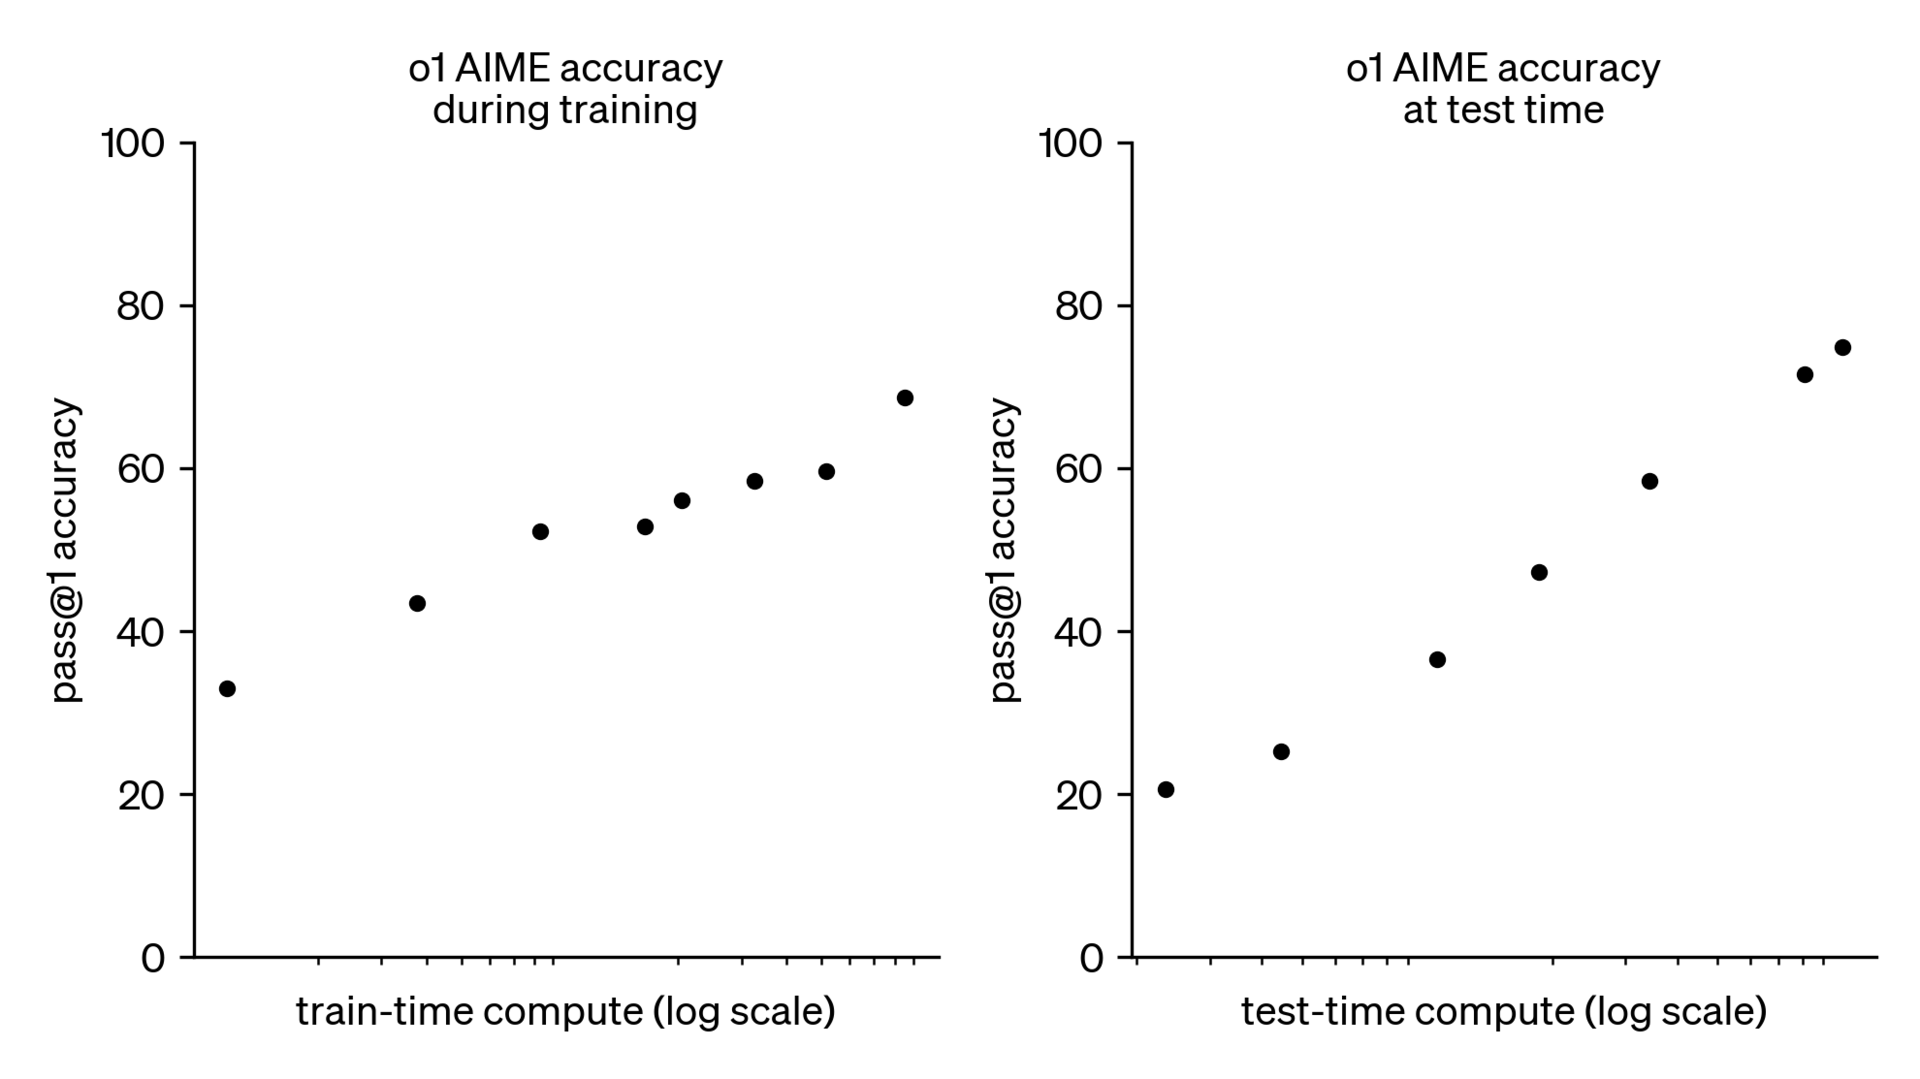
思维链提示(CoT prompting)由 Wei 等人在 2022 年明确提出,此前学术界亦有关于测试时计算分配(test-time compute)的系统研究。o1 的进展在于通过大规模强化学习将推理阶段的算力消耗机制化。[9][10]
Seed Edge 团队的 EdgeBench 则将 test-time scaling 推进到长时间跨度的真实环境交互。智能体在持续获取环境观测与执行反馈的过程中修改方案并验证执行结果,部分任务持续交互时间超过 72 小时。跨任务统计显示,平均得分随交互时间的对数增长呈现 log-sigmoid 函数趋势。[11]
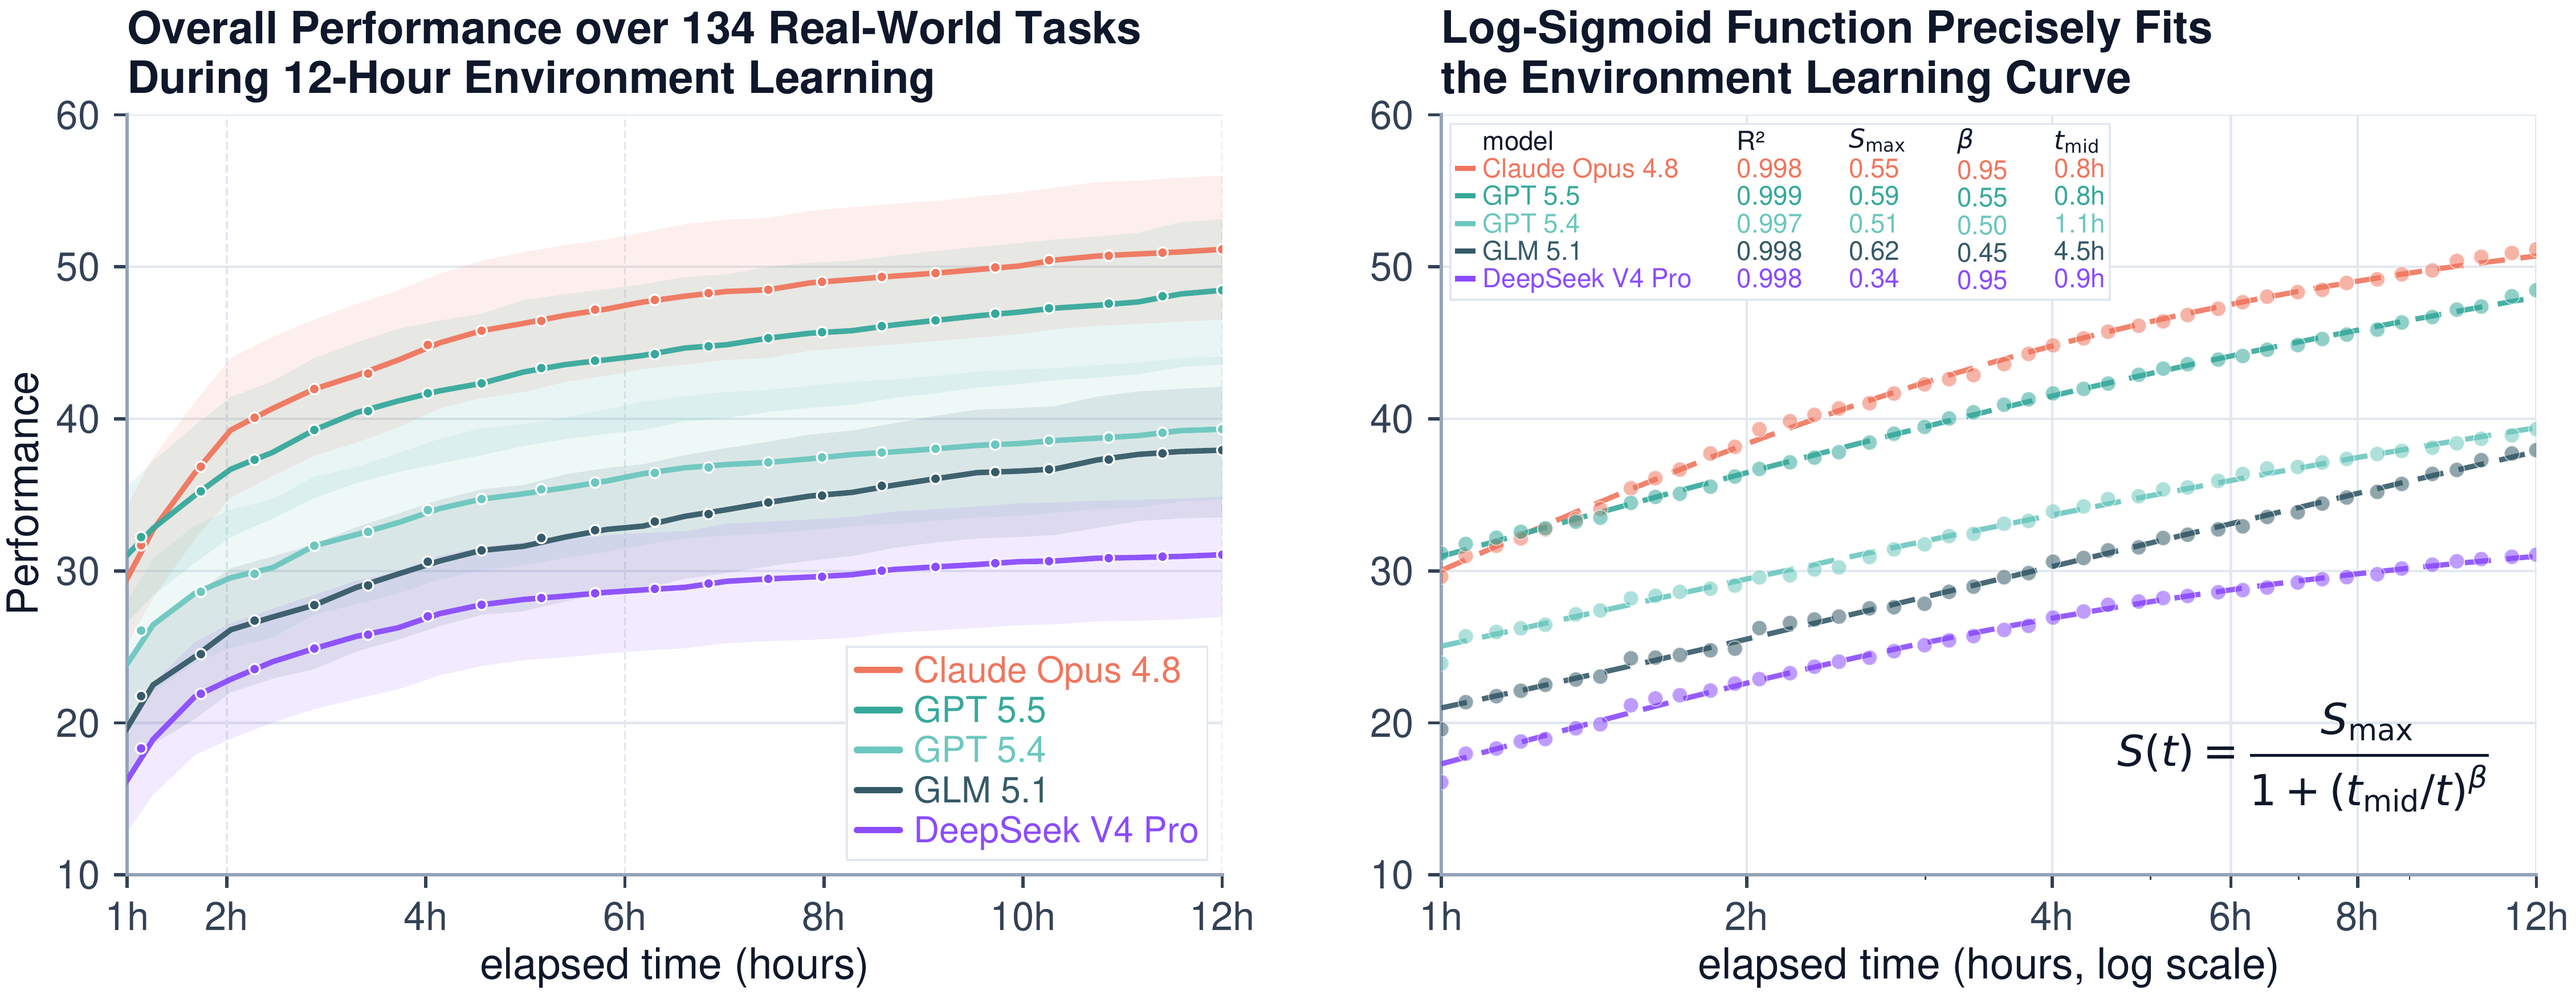
在此类长程交互中,新经验保存在上下文序列、外部环境日志与修改后的工程文件中,无须对模型权重进行在线更新。预训练构建了模型理解环境反馈并快速调整策略的基础能力,推理与交互阶段则将这一基础转化为实际复杂任务的执行收益。
这两项进展界定了算力扩展的两个核心路径。training-time scaling 通过扩展离线训练计算构建基础表征与模型容量;test-time scaling 则在固定权重的前提下,通过推理扩展、启发搜索或多轮环境交互提升当前任务的执行质量。
5. 效率与训练稳定性
计算扩展的可行性取决于资源投入的转化成本与工程实现的可靠程度。在预训练中,计算效率决定了既定预算下能够达到的模型性能上限,训练稳定性则决定了理论收益能否在长期分布式训练中完整兑现。
算法层面的效率提升对应 scaling 曲线的向左平移,即达成目标损失值所需的计算资源减少。以训练数据量为横轴时对应 token 效率(token efficiency),以总计算量为横轴时对应计算效率(compute efficiency);最终能耗则同时受制于模型架构、硬件利用率(MFU)与单 token 计算开销。
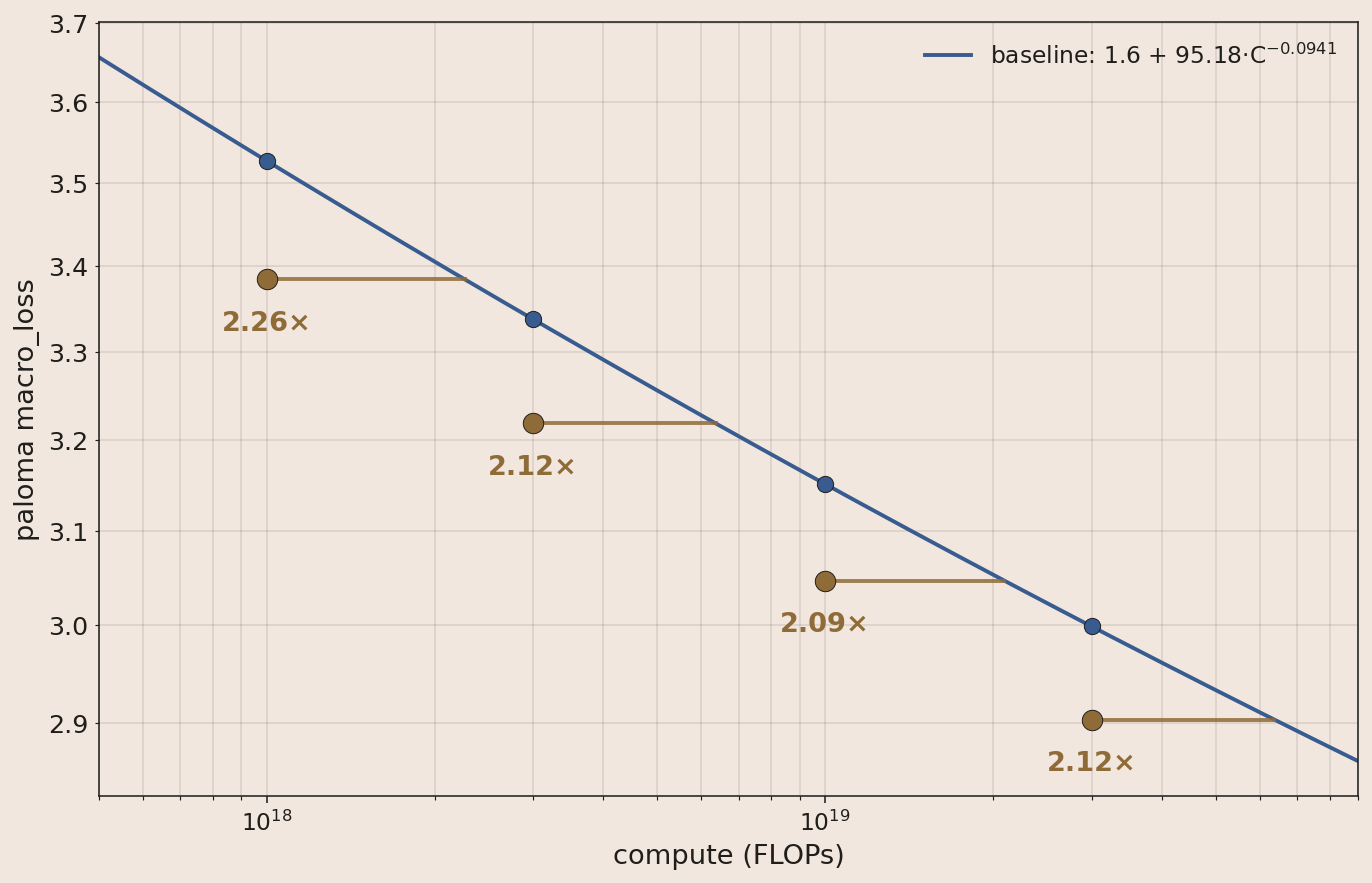
训练稳定性聚焦于长期训练过程中的数值与优化异常,具体包括激活值离群点(outlier)、梯度范数(gradient norm)、权重范数(weight norm)、logits 异常增长以及损失尖峰(loss spike)。对于数万亿参数规模的超大规模模型,未受控制的数值漂移极易引发梯度爆炸或训练发散。
Kimi K2 团队在模型扩展过程中遇到 attention logits 异常放大的现象,随后采用 MuonClip 算法中的 QK-Clip 机制约束 Q、K 投影层权重,完成了 15.5T tokens 的全流程预训练,且在训练期间未出现损失尖峰。[12]
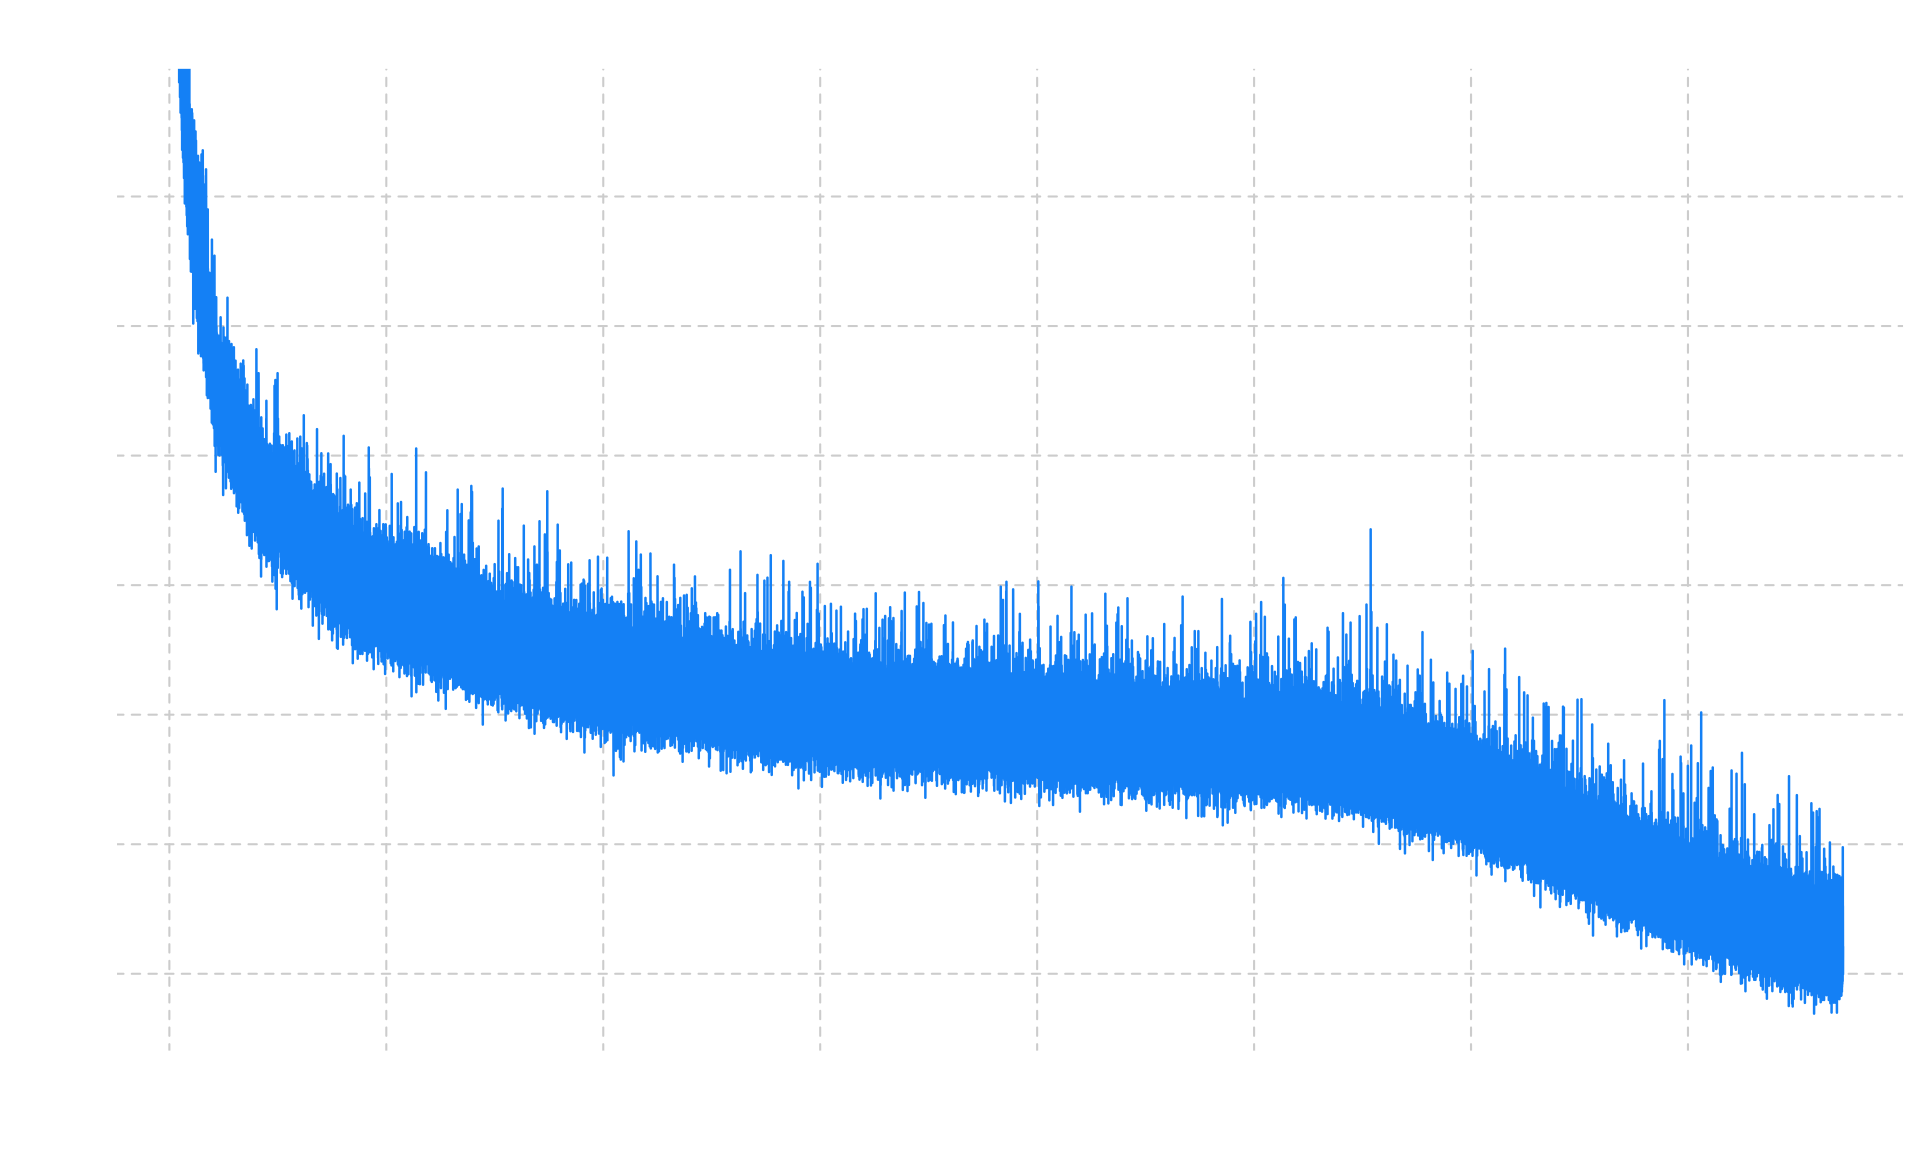
训练过程允许符合预期的数值动态与正常波动。对训练配方的调整,应当基于全局训练动态追踪以及数值变化对最终收敛损失的实际影响。
6. 可预测性与精细研究
在进行大规模计算投入前,需要检验小规模实验中获得的效率优势与数值动态能否向外推导至目标尺度。因此,外推的可预测性构成了规模扩展研究的关键依据。
Scaling laws 为工程资源配置提供了定量参考。准确的外推要求严格限定变量、观测指标与拟合模型的适用边界:预训练损失的幂律拟合、对数坐标轴上的基准评测得分,以及长期环境交互的 log-sigmoid 曲线,具有不同的数理特征与解释范围。[13]
Marin 团队在 535B-A23B 稀疏模型的训练记录中公开了完整的预测与监测实践:首先基于小规模模型序列构建 scaling ladder 预测大模型的全局损失轨迹与梯度动态,随后在真实训练过程中比对观测值与预测值。小规模运行建立的动态基准,有助于快速区分正常的数值演变与需要介入调查的工程偏差。[14]
Delphi 项目的早期实验展示了外推失效的典型场景。在小规模实验中拟合精确的 scaling law,扩展至 $10^{22}$ FLOPs 预算时实际损失超出预测值 2.5%,而在 $10^{23}$ FLOPs 的运行中训练直接发散。这一结果表明,局部小规模实验拟合良好,无法确保大尺度训练在外推时依然符合预测。[17]
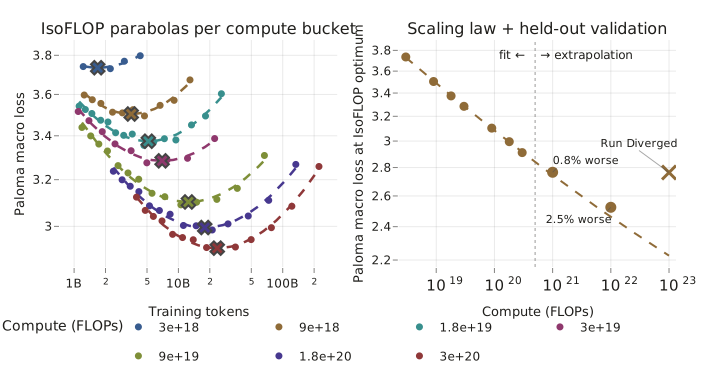
随后团队改用 AdamH 优化器,引入随训练 token 总数修正的学习率调度机制并重新调优超参数。改进后的实验在 $10^{23}$ FLOPs 计算预算下顺利完成训练,最终损失与预测值的偏差收敛至 0.2% 左右。通过失效结果排查工程原因并修正训练配方,是建立可靠扩展预测的典型途径。
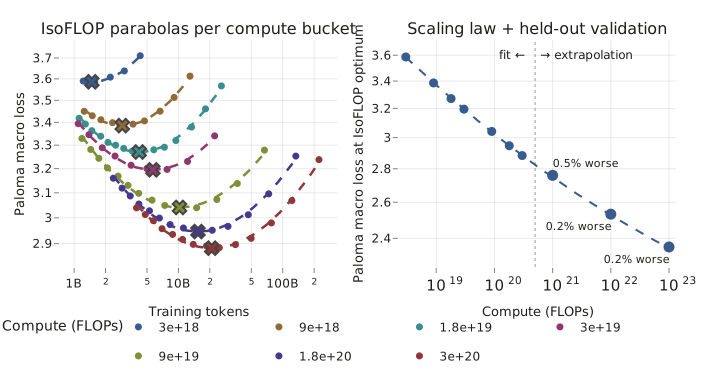
在工程监测方面,Marin 通过 scaling ladder 及时发现了梯度异常增长现象,并引入 logit z-loss 稳定输出分布;其公开配方中亦记录了基于超球投影优化的 MuonH 方案。具体改进的收益需要在特定工程体系(scaling ladder)中逐项验证。[15]
Greg Yang 等人提出的 Tensor Programs V 则从理论层面为规模扩展提供了参数化支撑:最大更新参数化(μP)确保神经网络在宽度扩展极限下,大量关键超参数(如最优学习率)保持恒定,从而使 μTransfer 能够将小尺寸模型的超参数调优结果直接零样本迁移至超大模型。[16]
通用学习框架的设计可以保持简洁,但规模扩展的实现依赖严谨的精细工程。网络参数化、优化器选择、数据配比与训练过程动态,共同决定了外推预测在大尺度下能否成立。
7. 总结
GEN-1.5、o1 与 EdgeBench 表明,通用学习框架能够在不同模态与任务阶段持续转化经验与计算投入;Marin 与 Delphi 的工程实践则表明,要稳定兑现规模扩展的红利,必须建立严密的定量预测、偏差诊断与配方修正机制。
预训练将多源经验结构沉淀为可复用的模型权重,降低后续任务的适应成本。Scaling 则贯穿模型生命周期的两端:training-time scaling 扩展基础表征与模型容量,test-time scaling 将额外算力转化为特定复杂任务的推理与决策增益。尽管不同领域的实现细节与规模曲线存在差异,其依托算力与数据进行能力提取的科学方法具有相通性。
方法论的核心在于构建能够支撑持续学习与规模扩展的有效条件;科学观的核心在于要求资源投入与能力改善之间的映射关系具备可预测、可检验与可修正性。计算效率决定既定资源下的收益上限,训练稳定性保障大规模优化过程的可靠收敛,而外推可预测性则为进一步扩大工程预算提供了决策基准。
参考文献
[1] Generalist Team (2026). GEN-1.5: Embodied Foundation Models are One-Shot Learners. Generalist Blog.
[2] 张小珺、杨植麟(2024)。和杨植麟聊大模型创业这一年:人类理想的增量、有概率的非共识和 Sora。《张小珺 Jùn|商业访谈录》,第 59 期。
[3] Dyna Robotics (2026). Dyna-2: A 1-Million-Hour Scaling Law for World-Action Models. Dyna Research.
[4] Sutton, R. S. (2019). The Bitter Lesson. 个人文章,PDF 副本。
[5] Karpathy, A. (2017). Software 2.0. Medium.
[6] Kaplan, J., McCandlish, S., Henighan, T., et al. (2020). Scaling Laws for Neural Language Models. arXiv preprint arXiv:2001.08361.
[7] Hestness, J., Narang, S., Ardalani, N., et al. (2017). Deep Learning Scaling is Predictable, Empirically. arXiv preprint arXiv:1712.00409.
[8] OpenAI (2024). Learning to Reason with LLMs. OpenAI Blog.
[9] Wei, J., Wang, X., Schuurmans, D., et al. (2022). Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. arXiv preprint arXiv:2201.11903.
[10] Snell, C., Lee, J., Xu, K., & Kumar, A. (2024). Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters. arXiv preprint arXiv:2408.03314.
[11] ByteDance Seed (2026). EdgeBench: Measuring Real-World Environment Learning and Discovering a New Scaling Law. Seed Blog.
[12] Moonshot AI (2025). Kimi K2: Open Agentic Intelligence. Kimi Blog.
[13] Weng, L. (2026). Scaling Laws, Carefully. Lil’Log.
[14] Marin Community (2026). [Hero Run] 535B-A23B on 18T Tokens. GitHub Issue #8435.
[15] Marin Community. MoE Recipe. GitHub 项目文档。访问日期:2026-09-07。
[16] Yang, G., Hu, E. J., Babuschkin, I., et al. (2022). Tensor Programs V: Tuning Large Neural Networks via Zero-Shot Hyperparameter Transfer. arXiv preprint arXiv:2203.03466.
[17] Held, W. (2026). Scaling Laws That Extrapolate 300× Past the Fit. Open Athena Blog.
[18] Dial, L. (2026). Improving our LLM Pretraining Efficiency. Open Athena Blog.
引用
如果您需要引用本文,请参考:
@article{zou2026pretrainscaling,
  title={pretrain 和 scaling 作为一种方法论和科学观},
  author={Zou, Jiaxuan},
  journal={Jiaxuan's Blog},
  year={2026},
  url={https://jiaxuanzou0714.github.io/blog/2026/pretrain-scaling-methodology-scientific-perspective/}
}
Enjoy Reading This Article?
Here are some more articles you might like to read next: