如何搭建一个科学的 Scaling Ladder
本文基于公开文献与技术报告整理,不含任何涉密内容,系统梳理如何通过小规模实验矩阵(Scaling Ladder)拟合 Scaling Law,外推目标规模下的模型结构、训练超参、最终 loss 与下游任务表现,在大规模训练启动前收敛配置风险。
1. 适用范围与术语
1.1 Scaling Ladder 的定义
Scaling Ladder 是一组按参数量 $N$、训练 token 量 $D$ 及其他受控变量系统排列的小规模训练实验。它的核心作用是用可控的实验预算拟合 Scaling Law,定量外推目标规模下的最优模型尺寸、训练时长、超参数与预期性能,避免在旗舰模型训练中盲目试错。
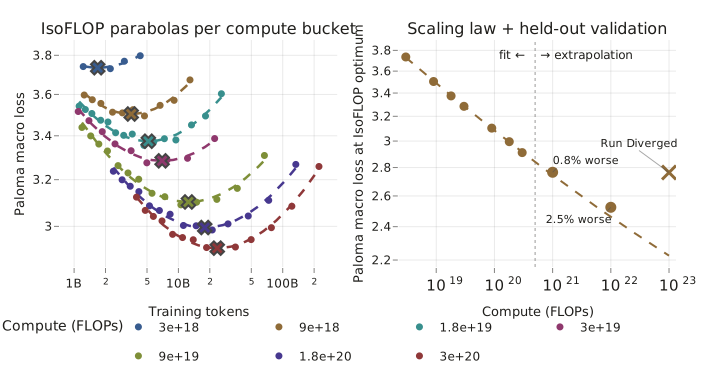
小规模拟合优度高并不自动保证大规模外推可靠。如图 1 所示,Delphi 首次采用的配方在拟合区间内表现平滑,但外推到 $10^{22}$ FLOPs 时 loss 偏高 2.5%,到 $10^{23}$ FLOPs 时直接发散。因此,Ladder 的设计不仅要包含拟合点,还必须通过样本外 holdout 与稳定性验证来检验外推精度(§10)。
1.2 典型场景
本文围绕三类预训练场景展开。第 2–10 章介绍通用主干流程,MoE 与数据受限场景的特殊处理在各章对应小节单独讨论。
| 场景 | 核心问题 | 对应章节 |
|---|---|---|
| Dense | 宽深比缩放规则与基础算力分配;既用于交付 dense 模型,也作为 MoE 的基准对照 | §4.3 |
| MoE | 总参数量与激活参数量解耦;稀疏率、专家粒度、路由与负载均衡;专家并行的真实吞吐 | §3.1、§4.4、§5.6、§6.6、§8.5、§10.3 |
| 数据受限 | 可用 unique tokens 少于目标训练量;重复轮数、数据质量与领域配比共同决定 loss 下界 | §5.3、§7.3 |
实际项目中 MoE 与数据受限往往同时存在,且受推理成本或数据储量影响,目标 TPP(tokens per parameter)可能显著偏离 Chinchilla 最优比值,实验矩阵的训练量轴需围绕目标 TPP 构建(§5.3)。
后训练(SFT/RL)自身的 scaling law、原生多模态以及蒸馏/合成数据生成管线不在本文讨论范围内;后训练仅作为检验预训练基底可塑性的验收环节出现(§2.2)。
1.3 Ladder 的产出
| 产出 | 外推目标 | 章节 |
|---|---|---|
| 超参 scaling law(LR、BSZ、WD) | 目标规模的最优训练超参 | §6 |
| Loss scaling law | 退火终点的 training / eval loss | §8.1 |
| Loss 曲线 scaling law | 完整训练轨迹与退火收益 | §8.2 |
| 退火比例 | LR decay 阶段占总训练量的比例 | §6.5(仅给出经验初值) |
| 数据配比与数据重复 scaling law | 最优领域权重;多 epoch 训练的等效 token 量 | §7 |
| MoE 稀疏度 scaling law | 固定激活参数下的专家总数与粒度配置 | §5.6、§8.5 |
| 下游任务 scaling law | 目标规模的 Benchmark 指标 | §9 |
1.4 术语与符号
| 术语 | 定义 |
|---|---|
| $N_{\text{body}}$ | Transformer 主干参数量,不含 input embedding 与 output head(§3.1) |
| $N_{total}$、$N_{active}$ | MoE 主干总参数量(含全部专家)与单 token 激活参数量 |
| $D$ | 累计训练 tokens,按实际参与 loss 计算的 token 统计(§3.3) |
| $U$ | 去重后的可用 unique tokens |
| $C$ | 训练总 FLOPs,按实际架构与算子口径统计(§3.2) |
| TPP | Tokens per parameter($D/N$);跨文献对比时需对齐 $N$ 的统计口径 |
| LR($\eta$)、BSZ($B$)、WD($\lambda$) | 学习率、batch size(统一按 tokens 计)、weight decay |
| Holdout | 留作外推精度检验、不参与函数拟合与方案筛选的大尺度实验点 |
| Fully-Tuned Frontier | 各尺寸实验点在超参充分调优后达到的 loss 包络线(§6.1) |
| 等效算力倍数 | 达到相同 loss 所需的算力比值,用于跨尺度统一衡量性能差异(§2.3) |
2. 决策目标与验收标准
2.1 决策目标
不同研究目标对 Ladder 的采样密度和调参深度要求截然不同,启动实验前需先明确目标类型:
- 既定配方外推:给定一套固定的超参缩放规则,预测其在目标规模下的表现,无需对每个网格点做穷举搜参。
- 最优算力分配:在给定预算 $C$ 下求解最优的 $(N, D)$ 组合。
- 候选方案对比:评估新架构、新优化器或新数据配比在目标规模下是否优于基线。
- 超参数跨尺度预测:拟合 $(\eta, B, \lambda)$ 随 $N$ 和 $D$ 的变化规律。
Delphi (Marin, 2026) 指出了一个常被忽视的区分:配方的性能竞争力(loss 是否足够低)与可预测性(小模型拟合能否准确外推大模型)是两件独立的事。目标 2–4 的前提是每个拟合点都已调到自身的最佳状态,即落到 Fully-Tuned Frontier 上(§6.1);若小模型超参欠调,拟合出的幂律斜率就会失真。目标 1 则直接沿用配方的预设规则运行。
2.2 评价协议
从训练 loss 到最终交付能力之间隔着多层非线性映射,评价体系设计需重点防范以下脱节:
- 代理指标与交付指标脱钩:小模型上 training loss 的微弱改善未必能传导到大规模下游任务(Qwen3.8-Next, 2026 §1)。
- 小尺度信噪比不足:在数学、代码等高门槛任务上,小模型的离散 accuracy 往往停留在随机猜测水平,而在简单任务上大模型又容易饱和。对小尺度无法拉开差距的指标,应改用正确答案的 bits-per-byte(BPB)等连续信号作为代理(OLMo 3, 2025)。
- 跨尺度排序翻转:小规模可分辨只说明信噪比够高,用作方案筛选时还需验证小尺度代理排名与大规模目标能力之间的秩相关性(OLMo 3, 2025 §3.3, Appendix A.4)。
- 单项高噪声干扰:评估集合应覆盖核心交付能力,对方差较大的任务通过多次采样取平均或单独跟踪,避免其波动掩盖整体趋势(Phi-4, 2024 §5;OLMo 3, 2025 §3.3.3–3.3.4)。
- 评测口径锁定:固定 prompt 模板、解码参数与打分脚本版本,并对训练集与评测集做严格的去重与污染检查。
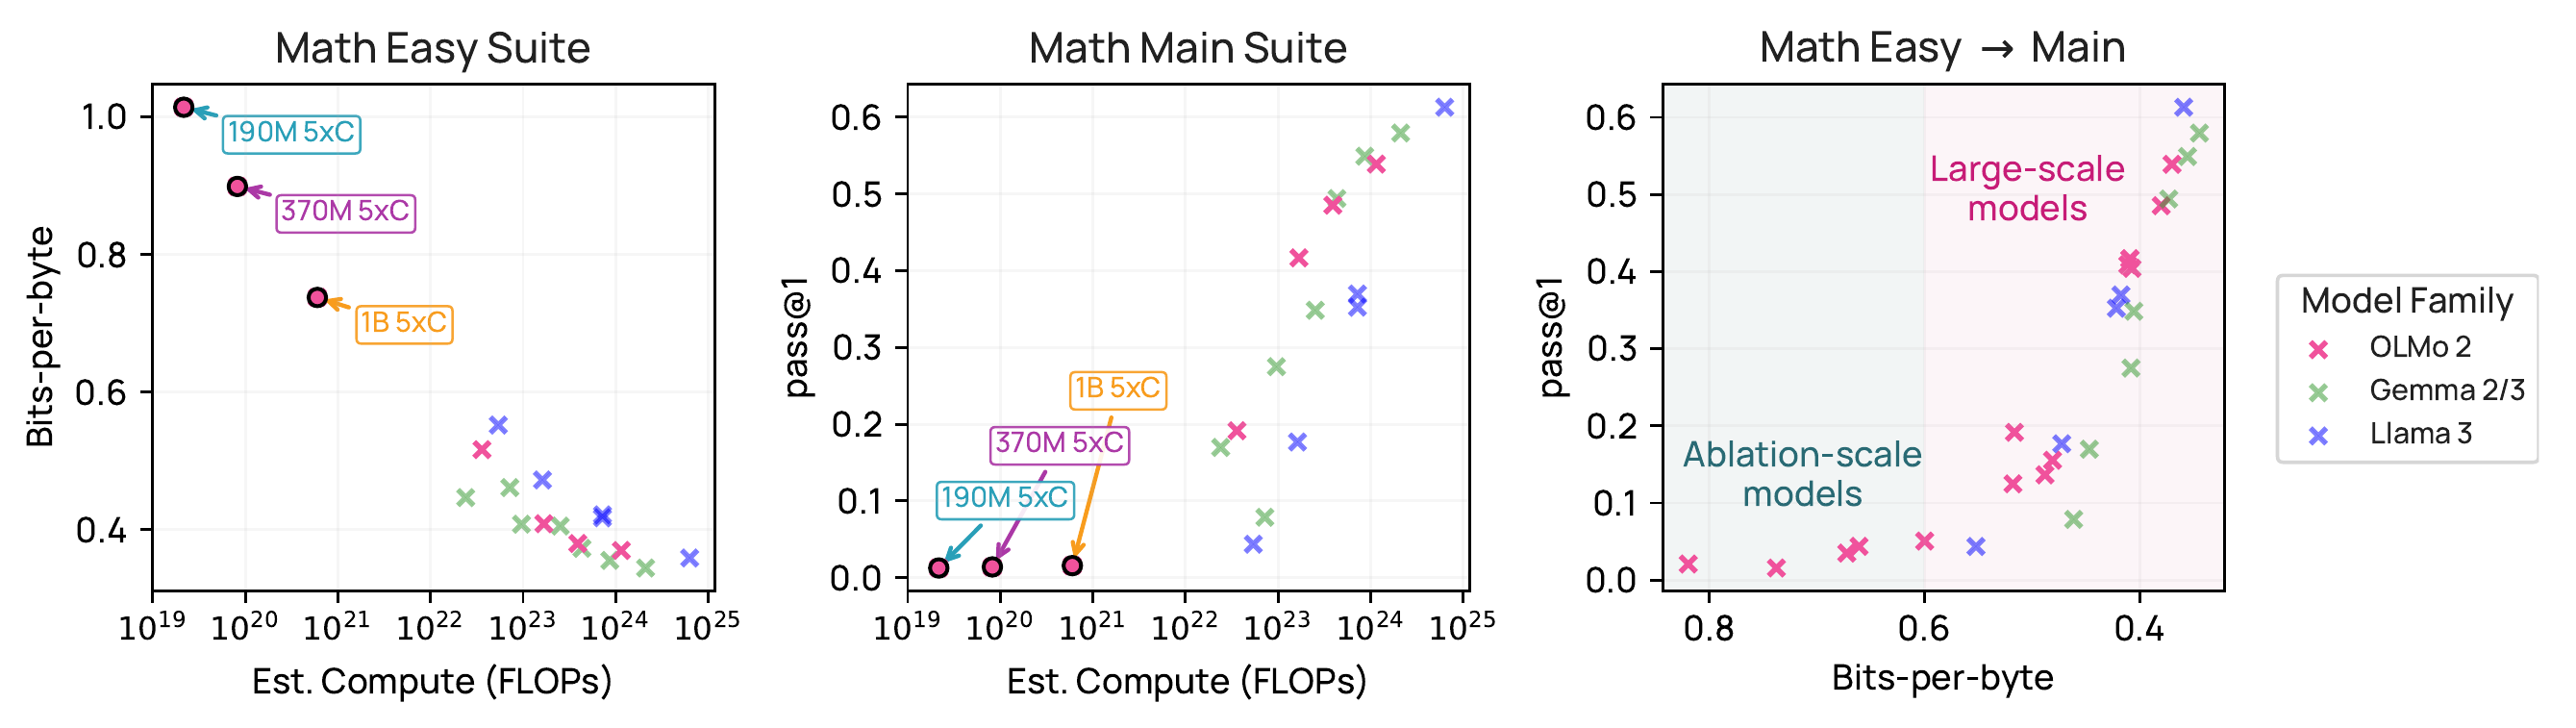
如果最终交付的是经过 SFT 或 RL 的后训练模型,仅看预训练指标还会漏掉后训练阶段的隐性退化。Qwen3.8-Next, 2026 报告了两个典型反例:去掉位置编码(NoPE)和引入稀疏读取残差分支在预训练阶段对 loss 影响极小,但前者在后训练后出现无法终止的重复生成,后者则导致后训练质量明显下滑。为此,OLMo 3, 2025 §3.5.1 在候选配比完成完整退火后,统一接入轻量级 instruction tuning,同时检查下游得分与生成终止行为、输出长度等表现。
2.3 验收阈值与判定规则
Ladder 的验收围绕四类问题展开:
- 固定配方在目标算力下的终点误差;
- 候选方案外推至目标规模后的性能差值与排序置信度;
- 所选 $(N, D)$ 配比相对于邻近可行配比的预期 loss 损失;
- 大规模训练的数值稳定性与核心能力下界。
验收阈值必须在查看 holdout 结果前根据种子噪声和最小有意义增益设定。Choshen et al., 2025 统计发现,文献中足以驱动架构或算法改动的最小相对改善约为 4%,而随机种子重跑带来的波动本身就可达 3.5%;Delphi 在特定设置下实现的 0.2%–0.5% 预测误差属于低噪声理想情形,不宜直接当作通用阈值。
此外,跨尺度验收不宜使用固定的相对 loss 误差。在幂律 $L(C)=E+A\,C^{-\gamma}$ 下,微小的 loss 差异 $\Delta L$ 折算为等效算力倍数满足:
\[\ln\frac{C_2}{C_1}\approx\frac{\Delta L}{\gamma\,(L-E)}\]随着模型变大、$L$ 逼近不可约熵 $E$,相同的 $\Delta L$ 对应的算力倍率会急剧放大。因此,用等效算力倍数(例如节省 15% 算力)配合绝对 $\Delta L$ 来定义阈值,比单纯看百分比 loss 误差更能反映真实的算力价值。
比较两个候选方案时,由于二者共用相同的采样网格与评估集,共源噪声会部分抵消,应直接估计差值 $\Delta L$ 的置信区间,而非将两条曲线的独立误差条简单相加。反过来,整体 loss 拟合误差小也不代表算力分配最优解稳定——Gemstones, 2025 §4.2 证明,改变参与拟合的网格点子集就足以让推导出的最优 $N/D$ 比例发生偏移。因此,拟合参数的不确定性必须一路传播到最终的决策量(方案差值或最优参数量)上。
3. 测量规范
3.1 参数量口径
拟合 $L(N,D)$ 与统计计算量 $C$ 时,对参数量 $N$ 的定义应当解耦。
拟合 $L(N,D)$ 时,建议使用排除 input embedding 和 output head 的主干参数量 $N_{\text{body}}$。原因在于 embedding 和 head 的参数量为 $O(Vd)$,而主干为 $O(d^2 n)$;在小模型上词表层占比很大,计入后会扭曲幂律指数。Farseer (Li et al., 2025) Appendix G 的消融证实,包含 embedding 的口径外推到 25.1B 时误差显著劣于 $N_{\text{body}}$;Kaplan et al., 2020 同样排除了 embedding。
但在计算训练算力 $C$ 时,output head 每处理一个 token 都要执行一次 $d\times V$ 的矩阵乘,即便与 input embedding 做了权重绑定(tied weights),这笔浮点运算也无法省去,必须计入 $C$;而 input embedding 本质是查表操作,只需单独记录其显存与访存开销。
跨文献引用系数或 TPP 时务必核对口径:Porian et al., 2024 Table 2 的 $N$ 计入了 output head 但不含 input embedding;而 Chinchilla 广为人知的 20 TPP 则是按包含全部 embedding 的总参数量计算的(Hoffmann et al., 2022 Appendix F)。
对于 MoE 模型,每个实验点需同时记录:
- 主干口径下的总参数量 $N_{total}$ 与单 token 激活参数量 $N_{active}$(embedding 与 head 另计);
- 路由专家总数 $E_{total}$、每 token 激活专家数 $E_{active}$ 及稀疏率 $S=E_{total}/E_{active}$;
- 共享专家的数量与尺寸,以及单个路由专家的尺寸(专家粒度);
- 路由机制与负载均衡策略(§4.4)。
3.2 计算量
教材式的 $C\approx6ND$ 省略了注意力矩阵乘和词表投影。以标准 MHA 与 $4d$ FFN 为例,若按完整 $L\times L$ 注意力矩阵计算,前反向总计算量为:
\[C \approx \left(6 + \frac{L}{d}\right) N_{\text{body}}D + 6VdD\]其中 $L$ 为序列长度,$d$ 为隐藏维,$V$ 为词表大小,$N_{\text{body}}\approx12d^2n$($n$ 为层数)。式中的 $L/d$ 项来自上下文注意力,末项来自 output head。若底层 FlashAttention kernel 跳过了因果 mask 的上三角区域,注意力项开销减半;采用 SwiGLU、GQA 或 MoE 时系数也会相应变化,实践中应按真实架构与算子口径统计 $C$。
MoE 模型的矩阵乘 FLOPs 按 $N_{active}$ 与路由器开销之和统计;专家并行(EP)引入的 all-to-all 通信虽然不产生 FLOPs,但直接拉长训练耗时,需在真实硬件效率评估中单独核算(§10.5)。
3.3 Loss 与 token 口径
为了让不同尺寸、不同批次的实验数据可比,Ladder 内部需统一以下统计口径:
| 维度 | 口径要求 |
|---|---|
| 主损失项 | 仅统计主任务 token 交叉熵;MoE 辅助损失、z-loss、MTP 等附加项单独记录,不混入拟合目标 |
| 评估集分布 | 所有候选方案共用固定的评测语料与领域权重,核心领域单列指标 |
| 损失聚合方式 | 明确按有效预测 token 还是按文档取平均,统一分布式归约的分母 |
| 序列拼接与掩码 | 统一 BOS/EOS、文档边界、packing 方式、attention mask、position ID 与截断逻辑 |
| Token 计数 | 区分流经模型的总 tokens、参与 loss 反传的有效 tokens、unique tokens 与重复轮数 |
| 随机种子控制 | 分别记录参数初始化、数据采样与 shuffle 顺序的种子,尽量采用配对种子对比 |
| 跨词表对比 | 在相同原始文本上换算为字节级指标(如 BPB),并对齐单位原始文本的真实计算开销 |
当实验涉及调整训练数据配比时,各方案在自身训练集上的 training loss 混杂了语料本身熵值的变化(例如代码占比高则自然 loss 低),不能用来评判模型好坏,必须以固定外部评估集上的 loss 为准。
此外,验证集评估间隔应按各运行总步数 $T$ 的固定比例(如每 2% 训练进度)触发,而非固定步数(如每 1,000 步)。否则长训练任务会产生远多于短任务的评估点,在拟合完整曲线时天然占据过高权重(§8.3)。
4. 基线配方与缩放规则
4.1 变量分类
搭建 Ladder 时,所有配置项应明确归入以下三类,避免混杂受控变量:
| 变量类别 | 角色 | 典型示例 |
|---|---|---|
| 固定不变量 | 全 Ladder 严格统一 | 模型家族、数据版本、优化器类型、序列长度 |
| 预设缩放规则 | 随 $N$ 或 $D$ 按既定公式联动 | LR(幂律或 $\mu$P)、BSZ(如 $D^{0.4}$ 先验)、warmup 比例 |
| 实验自变量 | 网格扫描或待拟合的目标量 | $N$、$D$、待搜索的最优 LR 与 BSZ |
其中最容易踩坑的是 warmup 步数。若在所有尺度上固定相同的 warmup 步数,小预算实验会有很大一部分训练量耗在 warmup 阶段,从而系统性带偏拟合出的 compute-optimal 指数(Porian et al., 2024)。因此 warmup 应按总训练量的固定比例缩放,例如 Delphi 统一取总训练量的 10%(附录 A.3)。
一旦基础架构、优化器、数据版本、数值精度或 tokenizer 发生变更,原有的缩放系数可能失效,应先在小尺度上做迁移性检验,再决定是局部微调系数还是重跑 Ladder(§12.3)。
4.2 架构与训练配置一致性
同一模型族内,除显式作为自变量的研究项外,各尺寸模型需保持结构与缩放规则一致:
| 架构属性 | 一致性要求 |
|---|---|
| 主干拓扑 | 统一架构(如全系 decoder-only Transformer) |
| 归一化层 | 统一位置与类型(如 Pre-RMSNorm) |
| 位置编码 | 统一编码与底数配置(如 RoPE) |
| 激活函数 | 统一类型与隐藏维倍率(如 SwiGLU) |
| Embedding 权重 | 全系保持 tied 或全系 untied |
| 注意力机制 | 统一机制与分组策略(如 GQA) |
| 宽深比演进 | 按既定比例同步放大宽度与深度(§4.3) |
| MoE 路由配置 | 路由算法、负载均衡机制与共享专家占比保持一致(§4.4) |
训练环境与外围配置同样保持锁定:
| 训练配置项 | 典型设置 |
|---|---|
| 序列长度 | 4,096 |
| 训练数据版本 | 锁定同一数据切分与配比版本 |
| 优化器 | AdamW |
| 验证集 | 锁定同一评估集(§3.3) |
| 评估频率 | 按总训练进度等比例触发 |
| 基础设施口径 | 统一 tokenizer、初始化分布、参数化方案与 loss 归约逻辑 |
小尺度代理模型的结构设计(如 GQA 的 KV 头分组比、head_dim、宽深比)应贴近目标大模型的真实走向,确保硬件访存特征与表达瓶颈一致。
4.3 宽深配置
在相同参数量 $N_{\text{body}}$ 下,改变宽度 $d$ 与层数 $n$ 的比值会改变注意力项 $L/d$ 的实际算力开销(§3.2)。虽然早期 Kaplan et al., 2020 发现宽深比在较宽区间内对预训练 loss 影响不大,但近年更精细的受控实验表明,宽深比会显著影响下游 benchmark 表现(Gemstones, 2025 §4.4)以及复杂推理能力(GLM-4.5, 2025)。因此 Ladder 内部应锁定统一的宽深缩放比例;若目标决策涉及加深网络或调整注意力头维度,需专门增设结构对照点。
4.4 MoE 结构缩放规则
除满足 §4.2 的常规要求外,MoE Ladder 还需显式规范以下结构维度:
- 专家粒度(Granularity):Krajewski et al., 2024 将单个专家尺寸作为独立缩放维度研究,证明沿用 dense FFN 尺寸作为专家大小的传统做法在几乎所有算力预算下都是次优的;切分更细粒度的专家能使 MoE 相对 dense 的优势随规模持续扩大。
- 共享专家:固定隔离出的共享专家数量及其与路由专家的容量比。
- 负载均衡策略:固定辅助损失系数或无辅助损失的偏置更新率。DeepSeek-V3, 2024 §2.1.2 采用动态偏置路由,在前 14.3T tokens 将偏置更新率设为 0.001,最后 500B tokens 设为 0。由于均衡强度直接牵动模型 loss 与 EP 通信吞吐的权衡,调整均衡超参应视为配方变更。
- 容量因子与 Token 丢弃:训练与推理的 capacity factor 需保持一致,并将 token 丢弃率作为核心监控指标;DeepSeek-V3 在训练与推理全程均不丢弃任何 token(§2.1.2)。
- 稀疏度(Sparsity):Abnar et al., 2025 在忽略显存与通信开销的条件下发现,固定训练 FLOPs 时提高稀疏度(即扩大 $N_{total}$)能持续压低预训练 loss;固定 $N_{total}$ 时,loss 随稀疏度呈 U 型抛物线,且最优稀疏度随总算力增长而升高。在多数下游任务上,表现主要由预训练 loss 决定而对稀疏度不敏感,但在 CoQA、SQuAD 等阅读理解任务上,激活比例更高的稠密模型表现更好。Ludziejewski et al., 2025 进一步在显存约束下对专家总数、$N_{active}$ 与 $D$ 做了联合建模(实验覆盖至 2.7B 激活参数 / 5B 总参数)。
4.5 词表与数值精度
- 词表大小:Tao et al., 2024 在 33M–3B 规模上的实验表明,最优词表大小随算力预算同步增长,现有大多数开源模型的词表偏小。由于改词表会同时改变 $O(Vd)$ 的计算开销与单 token 压缩率,跨词表对比必须统一换算为字节级 loss(§3.3)。
- 数值精度:Kumar et al., 2024(实验覆盖 1.7B 参数、26B tokens 以内)将训练与量化精度纳入了 scaling law:低精度训练等效于折减模型的有效参数量;同时,模型过训练程度(TPP)越高,后训练量化带来的性能退化越严重。因此,Ladder 实验应直接采用目标运行所用的低精度方案,切换精度方案需重新校准实现一致性(§10.4)。
5. 实验设计与预算
5.1 实验矩阵结构
典型的 $(N, D)$ 实验网格如下:
训练量 D →    0.5×    1×     2×     4×
模  130M       ●      ●      ●      ●
型  520M       ●      ●      ●      ●
尺  2.3B       ●      ●      ●      ●
寸  8B         ○      ○      ○      ○  ← holdout(不参与拟合)
N   ↓
- 拟合点(
●):在小至中等尺寸上扫描不同训练量,用于估计 Scaling Law 参数。 - Holdout 点(
○):在最大尺寸或更大算力档位留出样本外实验点,仅用于检验外推准确度。
采样网格的几何形状必须与拟采用的函数形式联合设计:
- 明确目标任务需要的是沿 $N$ 外推、沿 $D$ 外推还是 $(N, D)$ 联合外推,并在数据受限时同步标出重复轮数;
- 根据 §2.1 的任务类型,在完整网格、IsoFLOP 扫描或低成本的 L-shape 稀疏布局之间权衡(§8.1);
- 事先留出验证点与机动预算,应对拟合分歧或高噪声情形(§5.5)。
设计矩阵时尤其要注意参数可辨识性:如果所有实验点都只沿着同一固定 TPP(例如全部取 $D=20N$)采样,$N$ 和 $D$ 完全共线,回归时根本无法解耦二者各自的幂律指数。通过留出整档尺寸做交叉验证或检查参数协方差矩阵,可以提前发现这类病态采样。
5.2 尺寸数量、跨度与外推倍数
| 设计维度 | 经验准则 | 参考依据 |
|---|---|---|
| 模型尺寸档数 | 至少覆盖 3–4 个拟合尺寸并单设 holdout;增加尺寸档数有助于稳住斜率估计 | Choshen et al., 2025 |
| 尺寸跨度 | 朝目标方向拉开足够跨度;部分模型族跨越 34× 规模仍能保持幂律线性 | Choshen et al., 2025 |
| 相邻尺寸倍率 | 按等比数列递增(常见 $2\times$–$4\times$),兼顾对数轴均匀分布与算力预算 | 工程惯例 |
外推倍数定义为目标训练算力与最大拟合点算力之比。公开实践中,Delphi 在 $3\times 10^{18}$–$3\times 10^{20}$ FLOPs 区间拟合,在 $3\times$–$333\times$ 的 holdout 上检验外推;Llama 3, 2024 §3.2.1 在 $6\times 10^{18}$–$10^{22}$ FLOPs(40M–16B)上拟合,直接外推至 $3.8\times 10^{25}$ FLOPs,跨度约 $3,800\times$。外推倍数越大,函数形式微小的二阶偏差以及训练后期的数值失稳风险都会被急剧放大;当跨度远超最大 holdout 时,正式启动前应插入中等规模试运行(§10.6)。
5.3 训练量档位
训练量档位需围绕目标模型的预期 TPP 展开。最经典的方法是 Chinchilla(Hoffmann et al., 2022)的 IsoFLOP 扫描:固定多个算力预算 $C$,在每个 $C$ 下训练一组不同尺寸 $N$ 的模型,拟合并取 loss 最低点即可得到该算力下的最优 $(N_{opt}, D_{opt})$。
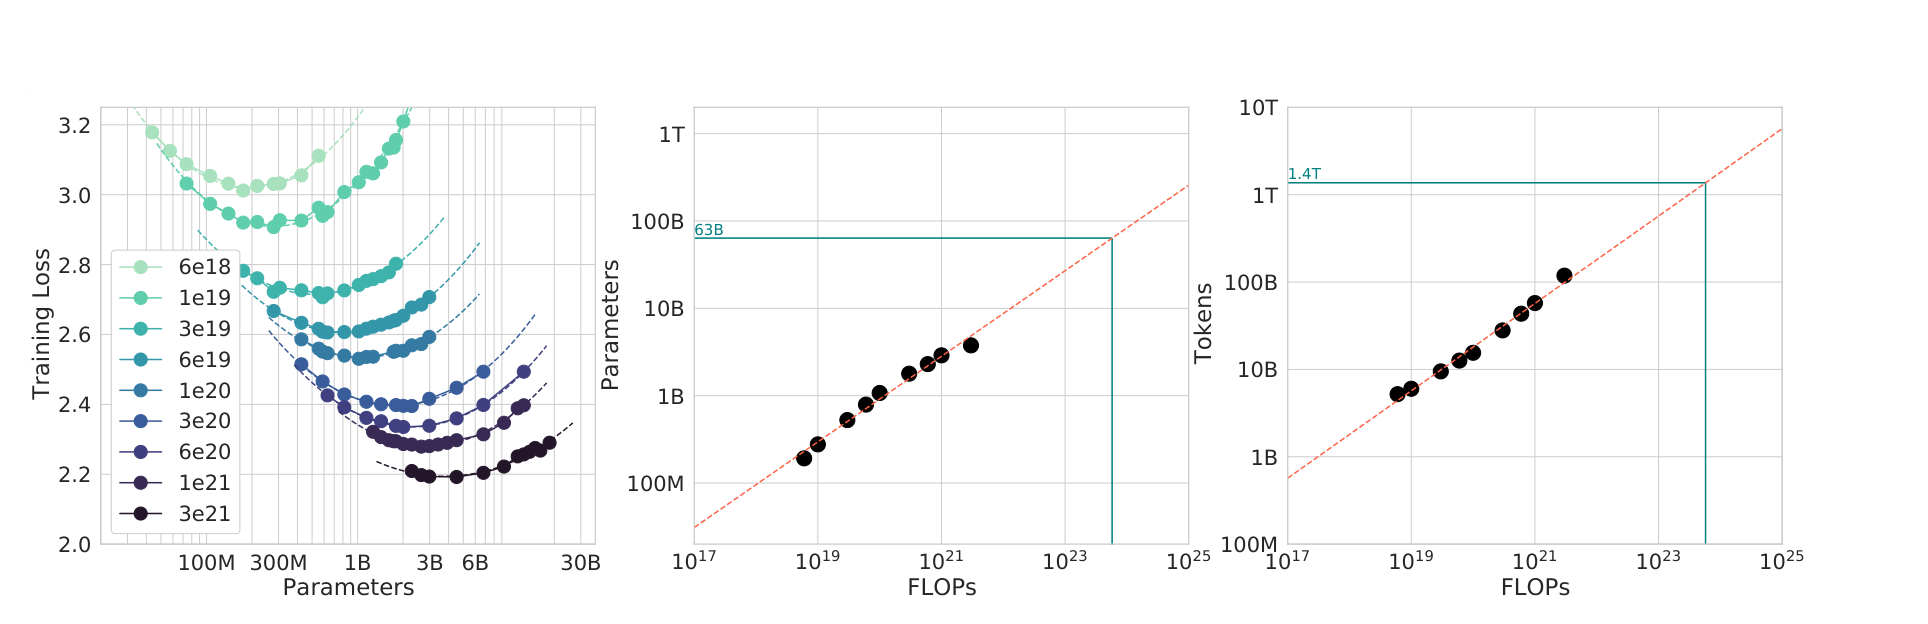
基于 400 余个模型(70M–16B,5B–500B tokens),Chinchilla 得出结论:
\[N_{opt}\propto C^a,\qquad D_{opt}\propto C^b,\qquad a\approx b\approx0.5\]即在算力最优前沿上,模型参数量与训练数据量应近似等比例放大。注意 Chinchilla 的 $D/N\approx20$ 是基于包含 embedding 的总参数量算出的;若换算为不含词表的 $N_{\text{body}}$,对应的最优 TPP 会更高,且具体数值随数据质量与配方而异。Llama 3 正是用同样的方法在 $3.8\times 10^{25}$ FLOPs 下算出最优尺寸约为 402B,最终定型为 405B(Llama 3 §3.2.1)。
设计训练量轴时需根据实际部署与数据场景调整跨度:
- 常规算力最优附近:通常取 0.5×–4× Chinchilla 配比,包住 1× 最优点的两侧;Fantastic Optimizers 则采用 1×、2×、4×、8× 四档来兼顾轻度过训练。
- 深度过训练区间:Gadre et al., 2024 在 104 个模型上验证了高达 32× Chinchilla 配比下的幂律外推稳定性。Sardana et al., 2024 的 47 组实验进一步推进到 10,000 TPP,发现 loss 虽仍在下降,但若只用常规低 TPP 数据拟合 Chinchilla 公式,会显著高估极端过训练下新增 token 的边际收益。因此高 TPP 目标必须包含高 TPP 的拟合与验证点。
- 计入推理成本的配比偏移:一旦把生命周期内的推理算力纳入总成本,最优解会系统性偏向“更小的模型 + 远超 Chinchilla 的训练量”(Sardana et al., 2024)。例如 Llama 3 405B 接近训练算力最优,而同步发布的 8B 与 70B 则被深度过训练至 15T tokens 以上,以压低部署侧延迟与显存成本(Llama 3 §1;见 §10.5)。
- 数据受限场景:当目标训练量 $D$ 超过去重后可用数据量 $U$ 时,矩阵中需同步标出重复轮数,并在拟合方程中引入衰减项(§7.3)。
5.4 中间 checkpoint、随机种子与共享轨迹
为了节省算力,研究者常把单次训练过程中的中间 checkpoint 一并纳入拟合(尤其在 WSD 调度下),但这会引入两个统计陷阱:
第一是早期高噪声阶段的污染。训练初期的 loss 剧烈下降且偏离稳态幂律,Choshen et al., 2025 在大规模复现中发现,剔除前 10% 进度或前 10B tokens 的早期点能显著降低外推误差。截断阈值应当在拟合前预先固定,或者像 Lourie et al., 2026 那样将模型尺寸切分为拟合段、验证段与测试段,在验证段上标定截断位置,切忌看着最终 holdout 反向微调截断点。
第二是轨迹内自相关与前缀共享。同一条训练轨迹上的连续 checkpoint 高度正相关,其有效自由度远低于同等数量的独立运行(§8.3)。同理,当使用 WSD 调度从同一条主干轨迹分叉出多条不同步数的退火分支时,这些分支共享了全部前期训练噪声,记账时既不能重复累加主干成本,做不确定性估计时也不能将它们当成彼此独立的样本。
5.5 预算分配与追加实验
Ladder 的总预算不仅包含主网格,还要覆盖先导探路、超参网格、多随机种子复验、退火分支以及故障重跑。更稳健的做法是分阶段投放算力:
- 先跑极小规模的探路实验,摸清当前配方的随机种子标准差、实际硬件吞吐以及候选方案之间的大致差距;
- 据此规划超参搜索、主网格拟合与 holdout 验收的算力切分,并留出约 15%–20% 的机动预算;
- 根据中期诊断定向补点:若误差主要来自种子波动,则在关键小尺寸上加跑多组随机种子;若不同候选函数形式(如 Chinchilla 与 Skaling)在高 TPP 或大 $N$ 区域预测分叉,则在分叉方向补跑区分点;若两个候选方案在长训练下出现曲线交叉,则延长代表性尺寸的训练步数。
在有限预算下,究竟是“多加一个大尺寸单次运行”还是“在小尺寸上多跑几个随机种子”更划算,取决于当前噪声水平与外推跨度的相对大小(Choshen et al., 2025)。
5.6 MoE 实验轴
MoE 模型的自由度远多于 dense,若对激活参数、总参数、专家粒度做全笛卡尔积扫描,预算会直接爆炸。实践中应将其拆解为三个正交的实验轴:
- 规模 Ladder(Scale Axis):锁定稀疏率 $S$ 与专家粒度,同步缩放 $N_{active}$ 与 $D$;
- 稀疏度 Ladder(Sparsity Axis):锁定 $N_{active}$、$D$ 与激活专家数 $E_{active}$,单独扫描总专家数 $E_{total}$;
- 粒度 Ladder(Granularity Axis):锁定 $N_{active}$ 与 $N_{total}$,同步调整单个专家尺寸与激活专家数(Krajewski et al., 2024)。
例如,Kimi K2, 2025 在固定 $N_{active}$ 与总 FLOPs 的条件下专门扫描 $E_{total}$ 构建稀疏度 scaling law,发现稀疏率从 8 提升至 48 时,达到相同 loss 所需的计算量持续下降,此时真正的上限约束来自跨节点通信与推理显存带宽。
在拟合时,三个实验轴的数据应各司其职,避免混入同一个未显式建模对应变量的简化公式中。同时,规模 Ladder 建议配齐同 $N_{active}$ 或同 FLOPs 的 dense 基线,用来量化 MoE 相对 dense 的等效算力倍数如何随规模演进。
6. 超参数搜索与训练配置
除了直接沿用既有配方的目标 1(§2.1)外,资源分配、方案对比与超参外推都要求先标定出最优超参 $(\eta_{opt}, B_{opt}, \lambda_{opt})$ 随 $(N, D)$ 的迁移规律。
6.1 搜参目标与近优区间
为什么小模型必须花大力气搜参,而大模型反而只做局部确认?Lourie et al., 2026 与 Step Law (Li et al., 2025) 揭示了一个关键非对称性:小模型对超参极其敏感,而大模型的最优点附近存在很宽的平坦盆地(Wide Plateau)。在小模型上,只要超参偏离最优值,loss 就会明显恶化并破坏幂律形态——干净的 Scaling Law 只在各点都充分调优的 Fully-Tuned Frontier 上成立。相反,在大模型上,Qwen3.8-Next, 2026 对 156B-A7B 模型将学习率乘除 $\sqrt{2}$、batch size 上调 25%,最终 training loss 的波动不超过 $7\times10^{-4}$。
这一现象直接决定了搜参算力的分配策略:把重度网格搜索集中投放在低成本的小模型上,确保每个拟合点的最优点严格落在搜索网格内部(而非卡在网格边界),且最优点邻域的局部联合扰动带来的 loss 变化小于随机种子噪声;到大模型阶段,只需在外推预测值附近做小范围验证即可(§6.7)。
6.2 参数化与优化器迁移
- 宽度迁移:$\mu$-Transfer(Yang et al., 2022)通过调整各层初始化与学习率缩放因子,使最优学习率在宽度方向上近似具备零样本迁移能力;引入非零 weight decay 时的修正规则见原论文 Appendix G.1.2 与 Power Lines。不过 $\mu$P 本身不解决跨 batch size 和跨训练长度 $D$ 的迁移,实践中常将 $\mu$P 参数化与显式的 $(N, D)$ 超参幂律结合使用。
- 深度迁移:Bordelon et al., 2023 通过将残差分支乘以 $1/\sqrt{\text{depth}}$ 结合 $\mu$P,在 CIFAR-10 与 ImageNet 的 ResNet 和 ViT 上实现了跨宽深度的超参迁移;但 Tensor Programs VI (Yang et al., 2023) 严格证明,Depth-$\mu$P 仅在每个残差块只含单层变换时成立,对于残差块内包含多层非线性变换的标准 Transformer,任何无限深度参数化都存在理论局限。因此在语言模型上改变层数时,仍需依靠经验幂律重新校准超参。
- 跨优化器迁移:切换优化器往往会彻底改变超参空间。Liu et al., 2025 在将 Muon 扩展至大模型时,通过引入 weight decay 并将正交化更新矩阵的 RMS 幅度对齐到 AdamW 常见的 0.2–0.4 区间(取 0.2),实现了直接复用 AdamW 的 LR 与 WD。但当架构与优化器同时调整时,Qwen3.8-Next, 2026 观察到切换到 Muon 后最优 LR 与最优 BSZ 依然发生了明显偏移,不能省去小尺度的重新标定。
6.3 LR 与 BSZ 的 Scaling Law
如果整个 Ladder 只跑单一的固定 $D/N$ 配比,可以直接把最优学习率和 batch size 拟合成总算力 $C$ 的单变量幂律:
\[\eta_{opt} = a \cdot C^{-\alpha}, \quad B_{opt} = b \cdot C^{\beta}\]DeepSeek LLM, 2024 给出的经验拟合即采用这一形式。但当 Ladder 覆盖多个 $D/N$ 档位(如同时包含常规训练与过训练)时,$C$ 把 $N$ 和 $D$ 混为一谈,必须将二者拆开建模:
| 代表方案 | $\eta_{opt}$ 公式 | $B_{opt}$ 公式 | 核心发现与适用边界 |
|---|---|---|---|
| Step Law (Li et al., 2025) | $c\cdot N^{-\alpha}D^{\beta}$ | $0.58\,D^{0.571}$ | 经 3,700+ 模型验证,支持跨 $D/N$ 外推;回归检验表明 $B_{opt}$ 主要由训练量 $D$ 决定,几乎不随 $N$ 变化(Appendix A.5) |
| Power Lines (Bergsma et al., 2025) | 由 timescale $\tau$ 联合锁定(§6.4) | $\propto D^{0.4}$(对 $N$ 依赖极弱) | 通过 EMA 时间尺度 $\tau$ 统一耦合 $(\eta, B, \lambda)$,需同时满足最大稳定 LR 与临界 batch 约束 |
| Token Horizons (Bjorck et al., 2024) | $c \cdot N^{-\alpha} D^{-\beta}$ | 固定 BSZ | 在固定 $N$ 与固定 BSZ 的前提下,训练 token 数 $D$ 越长,最优峰值 LR 越低 |
对比上表会发现一个耐人寻味的现象:Token Horizons 与 Step Law 中,$\eta_{opt}$ 关于 $D$ 的指数符号完全相反(前者为 $D^{-\beta}$,后者为 $D^{+\beta}$)。核心原因在于实验控制变量不同:Token Horizons 锁死了 batch size,训练越长步数越多,因而需要更小的学习率来精细收敛;而 Step Law 在增大 $D$ 时同步按 $D^{0.571}$ 放大了最优 batch size $B_{opt}$,大 batch 带来的梯度方差下降抵消并反转了步数效应,使最优峰值 LR 随 $D$ 微升。
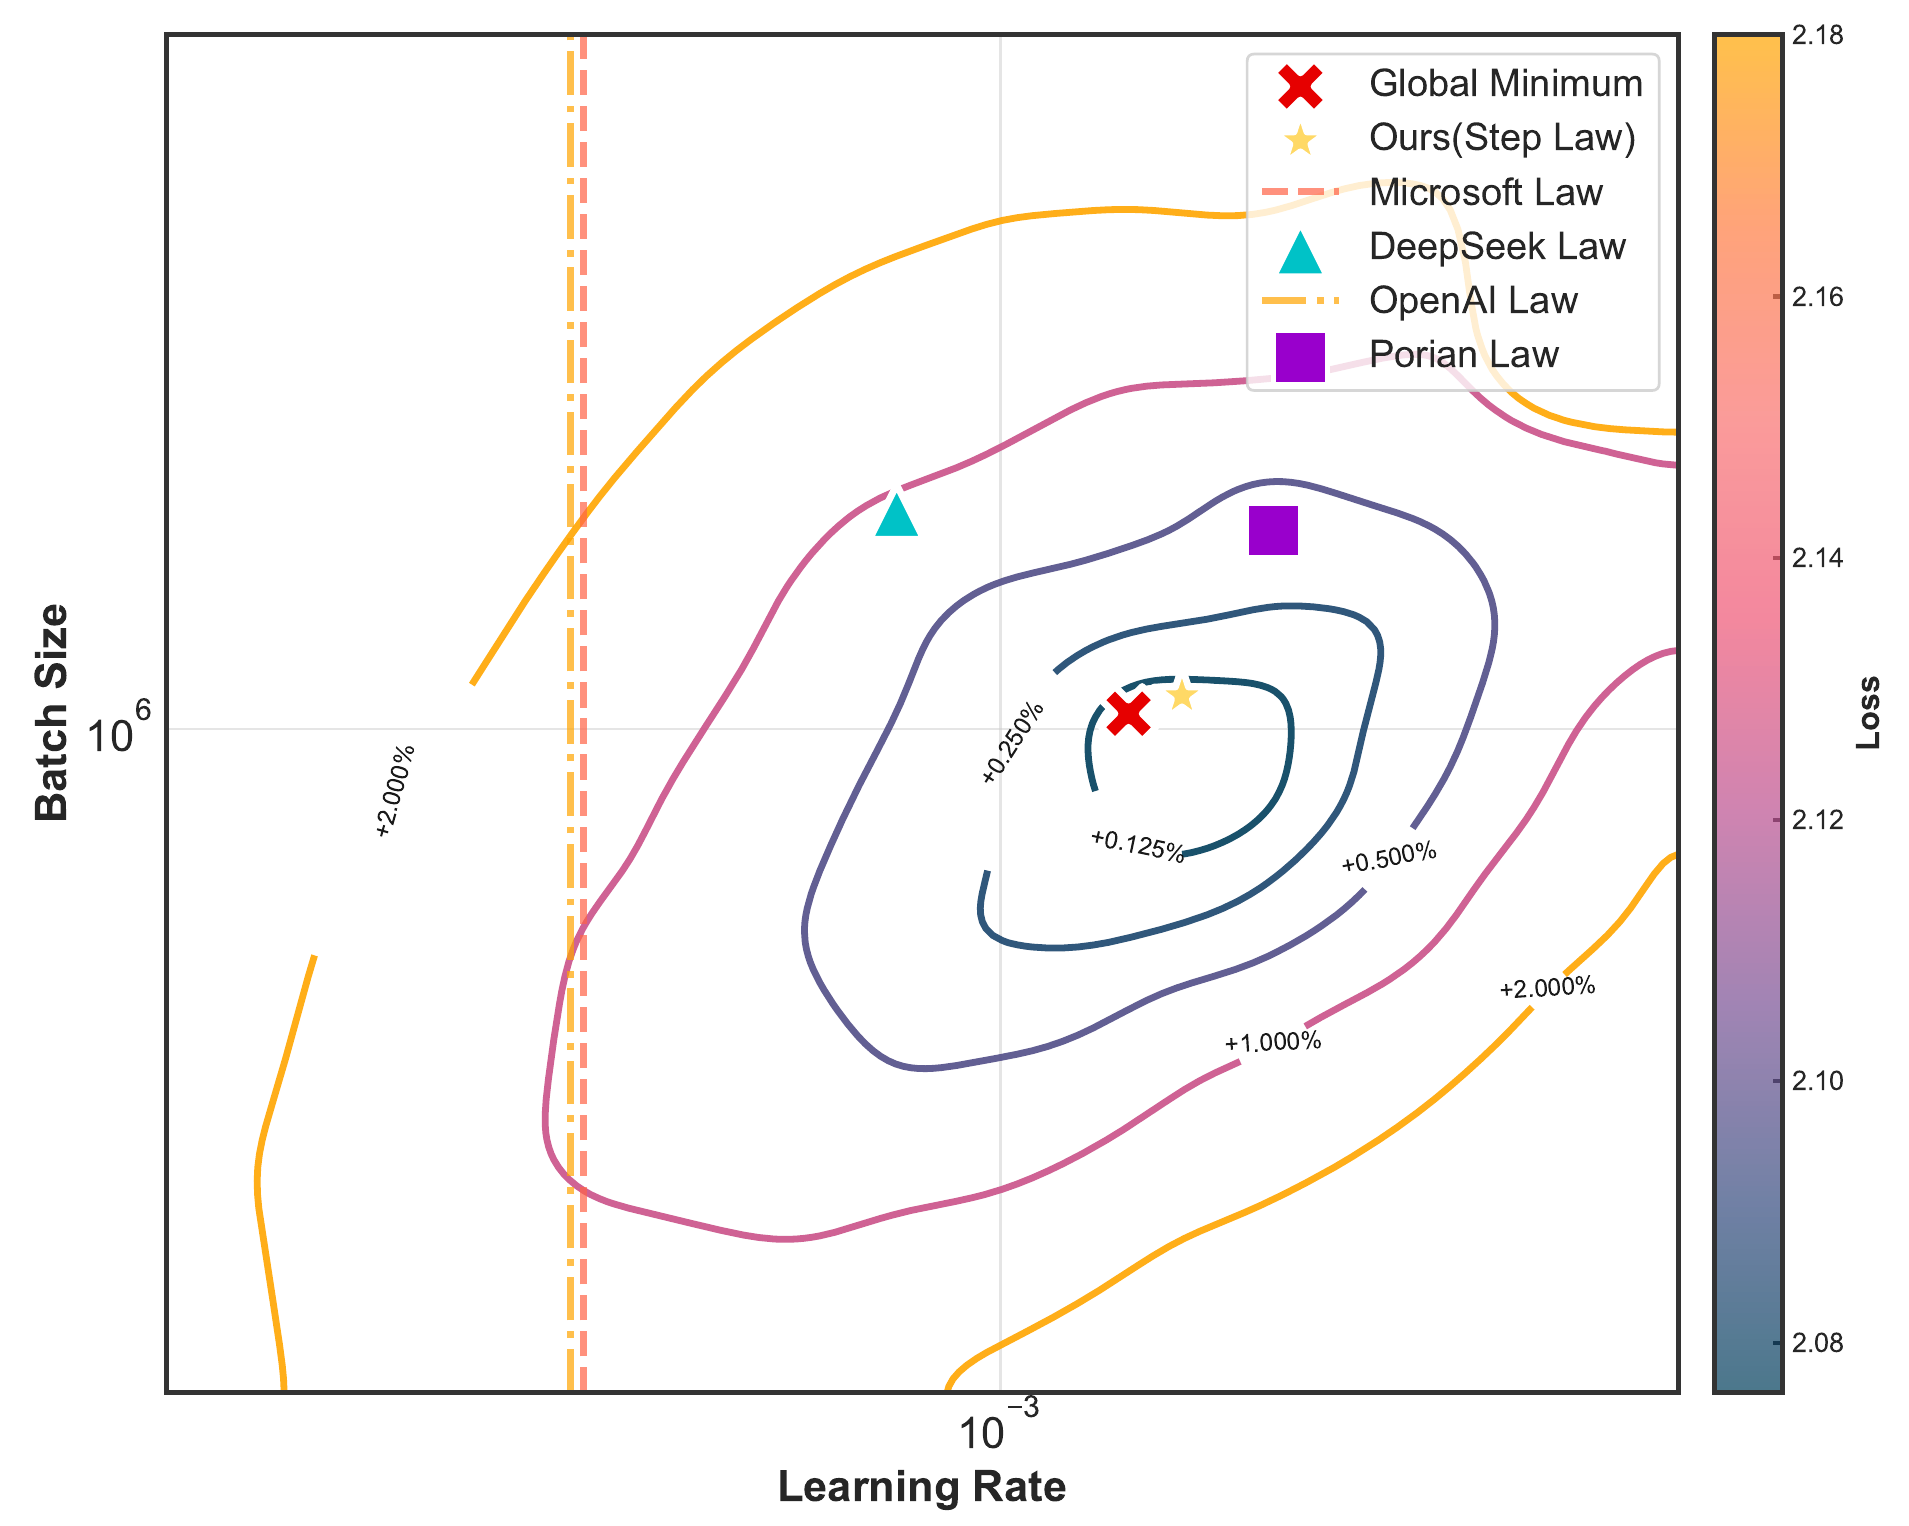
在最优 batch size 上,Step Law 与 Power Lines 得出了高度一致的结论:$B_{opt}$ 主要随训练数据量 $D$ 按幂律增长(指数约 0.4–0.57),而与模型尺寸 $N$ 基本无关。
除了绝对最优的 $B_{opt}$,Power Lines 还测量了临界批大小 $B_{crit}\propto D_{min}^{0.5}$(其中 $D_{min}$ 是无限小 batch 下达到目标 loss 所需的最少 tokens)。如图 5 所示,达到同一目标 loss 所需的训练 tokens $D$ 与更新步数 $S$ 在 $(D, S)$ 平面上构成一条双曲线:$B=B_{crit}$ 正好对应耗费 $2D_{min}$ tokens 的拐点;超过 $B_{crit}$ 后继续增大 batch size,步数收益急剧递减而总算力开销攀升。
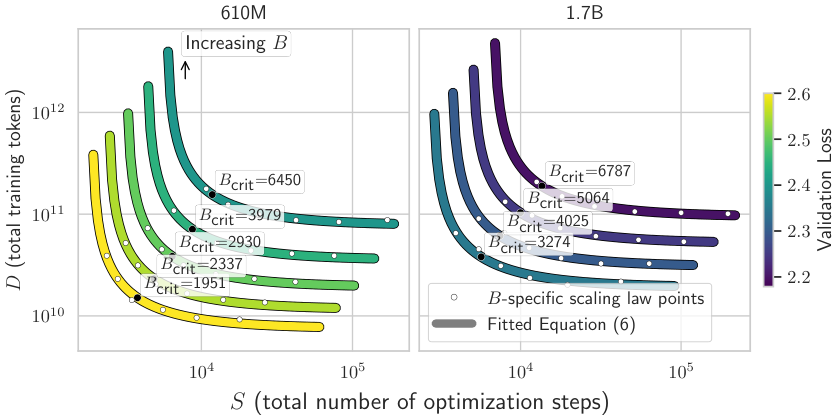
好消息是 batch size 的近优区间相当宽容:Schaipp, 2026 测算发现,算力浪费不超过 5% 的次优 batch 区间宽度约为 $4\times$,在对数对称模型下对应 $[B_{opt}/2, 2B_{opt}]$,这为工程上迁就硬件并行整除约束留出了充足余地。
实际操作中还需注意两点细节:
- 序列长度变化时,batch size 必须以总 tokens 数(而非序列条数)为单位保持守恒,并同步核算注意力开销与文档 packing 带来的边界变化。
- 不少超大规模训练采用动态递增的 batch size ramp(如 Llama 3 §3.4.1 将 BSZ 从 4M 分段拉升至 16M tokens,Nemotron-4, 2024 同样采用 ramp-up)。若小规模 Ladder 使用恒定 BSZ 而目标运行开启 ramp,需专门验证其对前期 loss 轨迹与等效超参的影响。
6.4 Weight Decay
许多开源技术报告直接将 weight decay 固定为常数(如 Kimi K2, 2025 全程取 $\lambda=0.1$;OLMo 3, 2025 在 AdamW 中固定 $\lambda$ 并排除 embedding;Qwen3, 2025 只对 LR 和 BSZ 做外推而不调 WD)。
但如果 Ladder 跨越较大的 TPP 范围,固定 WD 会引入偏差。Han et al., 2026 发现,随着 TPP 增大,能使预训练 loss 最低的 $\lambda_{opt}$ 会单调下降;但与此同时,保持稍大的 WD 有助于维持模型权重的有效秩与后训练阶段的可塑性。
在 AdamW 下,可以用权重指数移动平均(EMA)的时间尺度 $\tau = B/(\eta\lambda D)$ 将三个超参统一起来:Power Lines 证明最优配置对应恒定的 $\tau_{opt}$——当改变 $B$ 或 $D$ 时,若在 $\mu$P 下保持 $\eta$ 不变,只需按比例调整 $\lambda \propto B/D$ 即可维持相同的权重遗忘半衰期,前提是 $\eta$ 不触碰最大稳定学习率上界(Power Lines §2.4)。
6.5 LR Schedule
目前主流预训练主要在两类学习率调度之间选择:
- Cosine 调度:warmup 后按余弦曲线平滑衰减至终值(常取峰值 LR 的 10% 或 0),适合事先确定单一目标训练步数的运行。
- WSD(Warmup-Stable-Decay):恒定学习率跑完绝大部分进程,仅在最后阶段快速退火。River Valley (Wen et al., 2024) 从损失曲面几何给出了直观解释:高学习率的 stable 阶段负责沿着狭长山谷的谷底快速推进,而末期的 decay 阶段则让参数收敛到陡峭的谷壁底部。WSD 的最大工程优势是可以在一条长 stable 轨迹的不同位置切出多条退火分支,以极低成本扫描多个 $D$ 档位。
WSD 的退火阶段占比通常取总步数的 10%–20%(Tissue et al., 2024);Wang et al., 2025 系统验证了退火曲线形态与退火比例的跨尺度迁移规律。
6.6 MoE 训练超参
MoE 的激活稀疏性改变了梯度噪声结构,因此其 $(\eta_{opt}, B_{opt})$ 的幂律系数应在 MoE 家族自身上直接标定,不宜未经检验地照搬同激活规模 dense 模型的拟合值。路由器相关的超参(如负载均衡系数或偏置更新步长、router logits 的 FP32 精度、capacity factor)则应按 §4.4 锁定,并在放大规模时重点盯防专家负载极化或隐性的 token 丢弃。
6.7 搜索流程与停止规则
超参对最终 loss 的影响存在明显的灵敏度梯度:峰值 LR 与 BSZ 是一阶主导项,LR schedule 与 WD 次之,$\beta_2$、$\epsilon$ 等数值稳定性参数只需在基线与大尺寸代表点上确认不发散即可锁定。实际搜参可按由粗到细的坐标下降推进(尺寸仅作示例):
- 在最小尺寸(如 130M)上铺开二维网格扫描 $(\eta, B)$,确保最优点完全落在网格内部;
- 在中等尺寸(如 500M)上用缩窄的网格锚定幂律斜率;
- 在大尺寸上直接以外推值为中心做局部校验:学习率在 $[\eta_{pred}/\sqrt{2}, \sqrt{2}\eta_{pred}]$ 内取点,batch size 在 $[B_{opt}/2, 2B_{opt}]$ 内取点,仅当边界点更优时才向外扩网(§6.1、§6.3)。
利用 §6.3 中 $B_{opt}$ 仅依赖 $D$ 的性质,以及 §6.4 中通过调整 $\lambda$ 校准 $\tau$ 的关系,可以把原本的三维搜参降维处理。
需要注意的是,当我们在带随机噪声的多次 trial 中挑选 loss 最低的配置时,必然会引入“赢家诅咒”式的选择偏差,导致所选配置的真实收益被高估(Cawley & Talbot, 2010)。消除这一偏差的做法很直接:搜参选出最优配置后,换一个新的随机种子独立重跑一次,以复验值作为最终填入 Scaling Law 拟合表的数据;同时切忌根据训练前期的 loss 排名提前杀掉高学习率或慢热型配置,因为退火阶段的排名翻转非常普遍(§6.8)。
6.8 配方比较
用 Ladder 对比不同优化器、架构或学习率调度时,最容易因基线欠调或评估过早得出错误结论:
- 对齐各候选方案的调参完备度:Fantastic Optimizers (Wen et al., 2025) 指出,许多论文报告新优化器大幅超越 AdamW,仅仅是因为直接沿用了未针对当前尺度调优的 AdamW 默认超参;当双方都经过同等密度的超参搜索后,差距会显著收窄。同理,Kimi K3, 2026 §3.2 发现同尺寸、同训练量下 cosine 与 WSD 的最优 $(\eta, B)$ 位置差异很大,唯有为两者分别拟合独立的超参 scaling law 后对比才公平——在各自充分调优后,cosine 的最终 loss 稳定优于 WSD,团队也据此切回了 cosine。
- 只在完整退火终点对比:Fantastic Optimizers 观察到不同优化器与超参在 stable 阶段的领先优势经常在 LR decay 阶段被反超,中途截断排名不可信。
- 跟踪增益随模型变大的衰减趋势:在 Fantastic Optimizers 的 8× Chinchilla 实验中,矩阵类优化器相对 AdamW 的 token 效率优势从 0.1B 时的 $1.4\times$ 一路缩小到 1.2B 时的 $1.1\times$(且算力加速还不等于真实墙钟时间加速)。任何单点小模型上的改善,都必须在至少三个尺寸上验证其增益斜率没有随规模归零。
6.9 收尾流程
现代预训练很少只跑一段均匀分布就结束。如果目标生产管线包含以下收尾操作,Ladder 拟合点也应对齐执行,否则预测出的基础 loss 与最终交付表现之间会存在系统性偏移:
- 退火期数据切分(Continued Training / Cooldown):在训练尾声切换至高知识密度、高质量的数据集并配合陡峭退火(Nemotron-4, 2024;OLMo 2, 2025),详见 §11.1。
- 权重平均(Weight Averaging):包括将同一起点独立微调的多个分支合并(Model Soups)或对单条轨迹做滑动窗口平均(LAWA;Sanyal et al., 2024)。特别地,Model Merging (ByteDance Seed, 2025) 在 1.3B 与 13B 规模上证明,对 WSD 恒定学习率阶段的 checkpoint 做权重平均(PMA),无需真正跑完退火就能逼近完整退火终点的下游表现,是极佳的低成本探针。
7. 数据 Ladder
数据 Ladder 在锁定模型结构与优化器的前提下,专门回答三个问题:新数据源值不值得加(§7.1)、多个领域怎么配比(§7.2),以及高质量数据不够一个 epoch 时最多能重复几轮(§7.3)。
7.1 数据质量与数据源评估
DeepSeek LLM, 2024 在对比不同代际的预训练语料时发现了两个重要规律:
- 高质量数据要求更大的模型尺寸:语料的信息密度与质量越高,算力最优分配越偏向扩大参数量 $N$ 而非单纯堆叠 $D$;
- Scaling Law 系数严重依赖数据集:不同语料拟合出的幂律指数不可跨数据集混用。
这也解释了为什么当 Kimi K3, 2026 §3.2 同时升级架构、清洗数据与调整训练配方时,团队选择推倒重做整套 scaling law,重新标定了 BSZ、LR、最优 TPP 与模型宽深比。
不过,日常评估单个新数据源并不需要每次都重跑整张二维 Ladder,工业界常采用三类轻量级探针:
- Checkpoint 微退火(Micro-annealing):OLMo 2, 2025 从中后期主干 checkpoint 分叉,将待测新数据与基础语料按一定比例混合并做短程退火,直接观察目标基准的涨跌(注意该结果仅反映退火期边际收益,不等同于从零训练的全程排序)。
- 小模型单域消融:Kimi K3 §3.1 直接在固定小尺寸模型上通过消融实验确定各领域的采样权重。
- 垂域合成数据注入:Nemotron 3 Ultra, 2026 将合成的法律推理数据混入 Nemotron 3 Nano 预训练,使 LegalBench 代理评测平均分从 64.6 跃升至 74.7,快速验证了垂域数据的有效性。
7.2 数据配比 Ladder
数据配比 Ladder 锁定模型尺寸 $N$、训练量 $D$ 与优化超参,仅改变 $m$ 个数据桶的采样权重向量 $\mathbf{w}=(w_1,\ldots,w_m)$。结合 Olmix, 2026、OLMo 3, 2025 §3.4.4 与 Marin 数据流程, 2026 的工程实践,一套完整的数据配比寻优可分为以下七步:
- 划分数据桶与盘点储量:按数据源、领域或实例级属性标签(如教育得分、代码、多语言、安全等级;Qwen3, 2025)切分数据桶,并在每次调整过滤阈值后重新统计各桶去重后的真实可用 token 量 $N_j$(Marin 数据流程, 2026)。若生产训练分阶段切换分布(如 Nemotron 3 Super, 2026 在 25T tokens 中前 80% 侧重多样性、后 20% 侧重高质量语料),需按阶段分别寻优(§11.1)。
- 设立强基线:以自然 token 比例采样和限制最大重复次数的 UniMax 作为必测基线;Marin 提醒,若代理回归或约束设置不当,搜出来的学习配比往往还不如这两个简单基线。
- 设计小规模代理实验:
- 代理模型尺寸:在 5× Chinchilla 训练量下,15M 及以上代理模型与 1B 目标模型的配比排序 Spearman 相关系数超过 0.89,而降到 1M 时相关性跌至 0.73(Olmix);OLMo 3 实操中选用 30M 模型训练 3B tokens。
- 同比例缩池以对齐重复率:小代理训练 token 少,若直接在全量数据池里采样,永远触发不了大规模训练时的多 epoch 过拟合。为此,Marin 将每个数据桶的可用池按代理模型的激活参数量等比例缩小,迫使小代理在相同的 791 tokens/active param 预算下经历与目标大模型完全一致的重复轮数。
- 采样组数与替代方案:拟合 log-linear 回归所需的代理实验组数随领域数 $m$ 线性增长,通常不少于 $3(m+1)$ 组,采样点从以自然分布为中心的 Dirichlet 分布中抽取。为进一步省算力,DeMix, 2026 提出为每个数据桶单独训练一个组件模型,直接通过权重插值合并来评估任意配比,其排序一致性甚至优于重新训练的小代理。
- 分任务拟合响应曲面:Olmix 对比发现,对每个下游任务单独拟合 log-linear 模型再汇总,在留出配比上的相关性高达 0.983,显著优于直接拟合单一聚合分数的 0.866。此外,Marin 指出回归函数必须能刻画非单调饱和——单一高质数据桶权重拉高时 loss 先降后平,一旦因池子太小引发过度重复,loss 反而回升;且由于 $\sum w_j=1$,单桶权重的边际相关系数受其他桶强烈耦合,在预训练主阶段与 cooldown 阶段符号都可能改变(Marin)。
- 带重复上限的约束求解:在优化器中显式加入单桶重复上限约束 $w_j \le k N_j / R$($R$ 为目标总训练量,$k$ 为最大允许 epoch 数;§7.3),并附加指向自然分布的轻量级 KL 正则(如 $\lambda=0.05$)以防极端偏科。
- 中等规模交叉确认:在正式投产前,将求出的最优配比放到中等尺寸模型上与自然采样和 UniMax 做完整对比(Marin)。
- 数据池局部更新后的增量复用:当只有少数数据桶发生增删时,Olmix 的 mixture reuse 策略通过锁定未变动桶之间的相对比例,仅重跑涉及变动桶的少量代理。在历经 5 轮迭代、最终扩展至 64 个领域的 1B/100B 实验中,该策略以减少 74% 代理实验的代价保留了全量重算 95% 的性能增益(相对自然分布提升 11.6%),支撑了 OLMo 3 的三轮数据迭代。
7.3 数据受限训练与重复
当目标训练量 $D$ 超出可用高质量 unique tokens 总量 $U$ 时,重复训练(multi-epoch)不可避免。此时首先要在全语料库层面做跨数据源全局去重——Marin 数据流程, 2026 在全局去重时发现,不同开源数据集之间存在惊人的隐性重叠,其中最大的重叠源来自 Nemotron-CC 及其合成改写版本;若只做单桶内部去重,名义上的“1 epoch”实际上已经包含了大量跨桶重复。
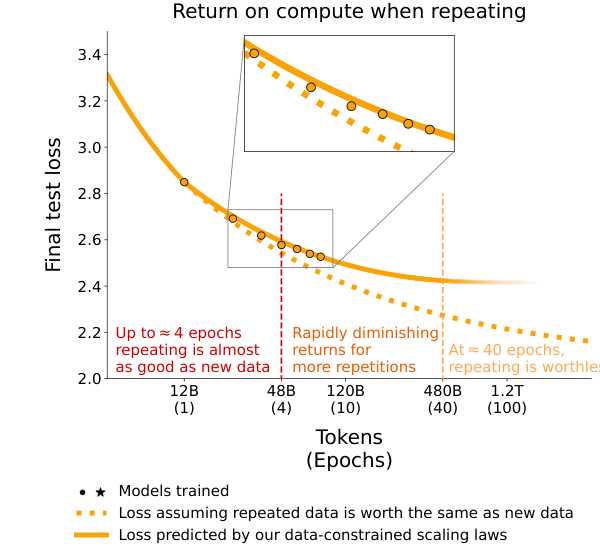
为了量化重复数据的收益折损,Muennighoff et al., 2023 假设每次额外重复的边际信息量呈指数衰减,定义了等效有效数据量 $D^\prime$:
\[D^{\prime} = U_D + U_D \cdot R_D^{\ast} \left(1 - e^{-R_D / R_D^{\ast}}\right)\]其中 $U_D$ 为 unique tokens 数量,$R_D$ 为额外重复轮数(单 epoch 时 $R_D=0$),$R_D^\ast$ 为半衰期尺度参数(实验拟合约在 4 左右)。当 $R_D\to\infty$ 时,无论再训多少轮,等效数据量最多只能收敛到 $U_D(1+R_D^\ast)$。
围绕多 epoch 重复的边界与缓解手段,近年研究给出了几条清晰的工程结论:
- 决定过拟合严重程度的是参数量 $N$ 与数据池大小 $U$:Yan et al., 2025 从线性回归理论推导出可承受的最优重复轮数随数据集样本量呈对数增长;Lovelace et al., 2026 与 Xue et al., 2023 的受控实验则一致表明,模型参数量 $N$ 越大、unique tokens $U$ 越少、重复轮数越多,记忆性过拟合就越剧烈。因此,在锁死 $U$ 的数据受限条件下,盲目放大 $N$ 只会加速过拟合,算力最优解会向更小的 $N$ 偏移。
- 正则化与高质量难抵大 $N$ 记忆:Xue et al., 2023 发现,在相同 unique token 规模下,单纯提高数据质量并不能消除多轮重复带来的过拟合恶化,反而开启适当的 dropout(v2 Table 4)对抑制重复过拟合有显著奇效。
- 混合通用数据能大幅拉高稀缺域的耐受轮数:如果只是把小体量的稀缺领域(如特定小语种或专业学科)混入海量通用语料中联合训练,其过拟合阈值会远高于单域孤立训练。Sedova et al., 2026 通过 2,000 余次训练发现,混合训练下稀缺目标语料重复 15–20 轮仍能带来净收益,且带重复项的混合 scaling law 可以从小模型稳定外推。
- 按质量分级控制重复上限:生产配方中普遍对单桶最大 epoch 数做硬截断(§7.2)。例如 Kimi K2.5, 2026 在基于 Kimi K2 末期 checkpoint 继续多模态联合预训练时严格限制各源 epoch 上限;OLMo 3(§3.4.4, Appendix A.2.5)则采用质量感知上采样,只对高分桶允许最多 7 轮重复,效果明显优于一刀切的高阈值过滤。
- 用多样性改写(Rewriting)突破机械重复瓶颈:相比把同一段原文翻来覆去训十遍,用大模型将高价值知识改写出多个句式版本能有效延缓记忆饱和。Kimi K2, 2025 §2.2 在 SimpleQA 上的对照极具说服力:原文直接重复 10 轮得分为 23.76,改写 1 次再训 10 轮升至 27.39,而生成 10 个不同改写版本各训 1 轮则达到 28.94(最终生产中对通用知识库限制最多改写 2 次,该策略在 Kimi K3 §3.1 中继续沿用)。统计口径上,改写生成的 token 与原始 unique token 应分列记录。
8. Loss Scaling Law 拟合
动用回归脚本拟合 $L(N,D)$ 前,务必确认 Porian et al., 2024 指出的三项历史偏差源已被排除:
- 算力 $C$ 已计入 output head 乘法,且与拟合自变量 $N_{\text{body}}$ 分开记账(§3.1);
- Warmup 步数已随训练预算按比例缩放,而非固定常数(§4.1);
- 对于目标 2–4,各拟合点均已搜参至 Fully-Tuned Frontier(§6.1)。
8.1 函数形式
Chinchilla 经典的加性幂律 $L(N,D)=E+A/N^\alpha+B/D^\beta$ 暗含了一个强假设:参数项与数据项完全解耦,混合偏导 $\partial^2L/\partial N\partial D\equiv0$。然而 Skaling (Videau et al., 2026) 在大跨度网格数据上检测到了显著为负的混合偏导,说明 $N$ 和 $D$ 之间存在互补耦合效应。为此,Skaling 在加性核外引入了一个耦合指数 $k$:
\[L(N,D)=\left(\frac{A}{N^{\alpha}}+\frac{B}{D^{\beta}}\right)^{k}+E\]当 $k=1$ 时公式退化回 Chinchilla;实测数据拟合出的 $k$ 落在 $0.31$–$0.45$ 之间。奇妙的是,引入外指数 $k$ 后,不仅只增加了 1 个自由参数,而且在固定算力下求解最优 $(N_{opt}, D_{opt})$ 的闭式代数结构与 Chinchilla 完全一致。
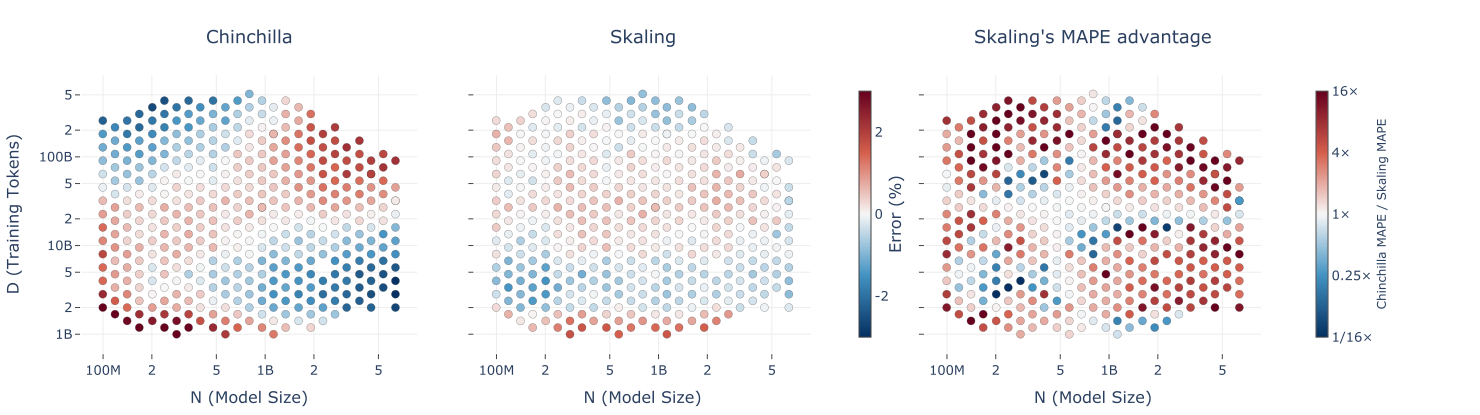
如图 7 所示,Chinchilla 加性形式在 $(N, D)$ 网格的四个角落(极端欠训练或极端过训练)会出现明显的马鞍形系统残差,而 Skaling 将全网格残差抹平到了零附近。与另一个同样试图刻画 $(N, D)$ 耦合、令数据侧系数和指数都随 $N$ 变化的九参数模型 Farseer (Li et al., 2025) 相比,仅有六个参数的 Skaling(Table 1)在 Farseer 与 SK-Grid 两套公开数据集上的插值和单轴外推误差反而更低。实践中建议将 Skaling 与 Chinchilla 并列为默认候选形式,在留出验证集上择优。
如果实验仅沿着单一固定 TPP 展开,二元函数会退化为关于总算力的一维幂律 $L=G(M)/C^\gamma+E$(其中 $M=D/N$);但只要涉及跨 TPP 比较或求解算力分配,就必须回到 $(N, D)$ 二元形式。
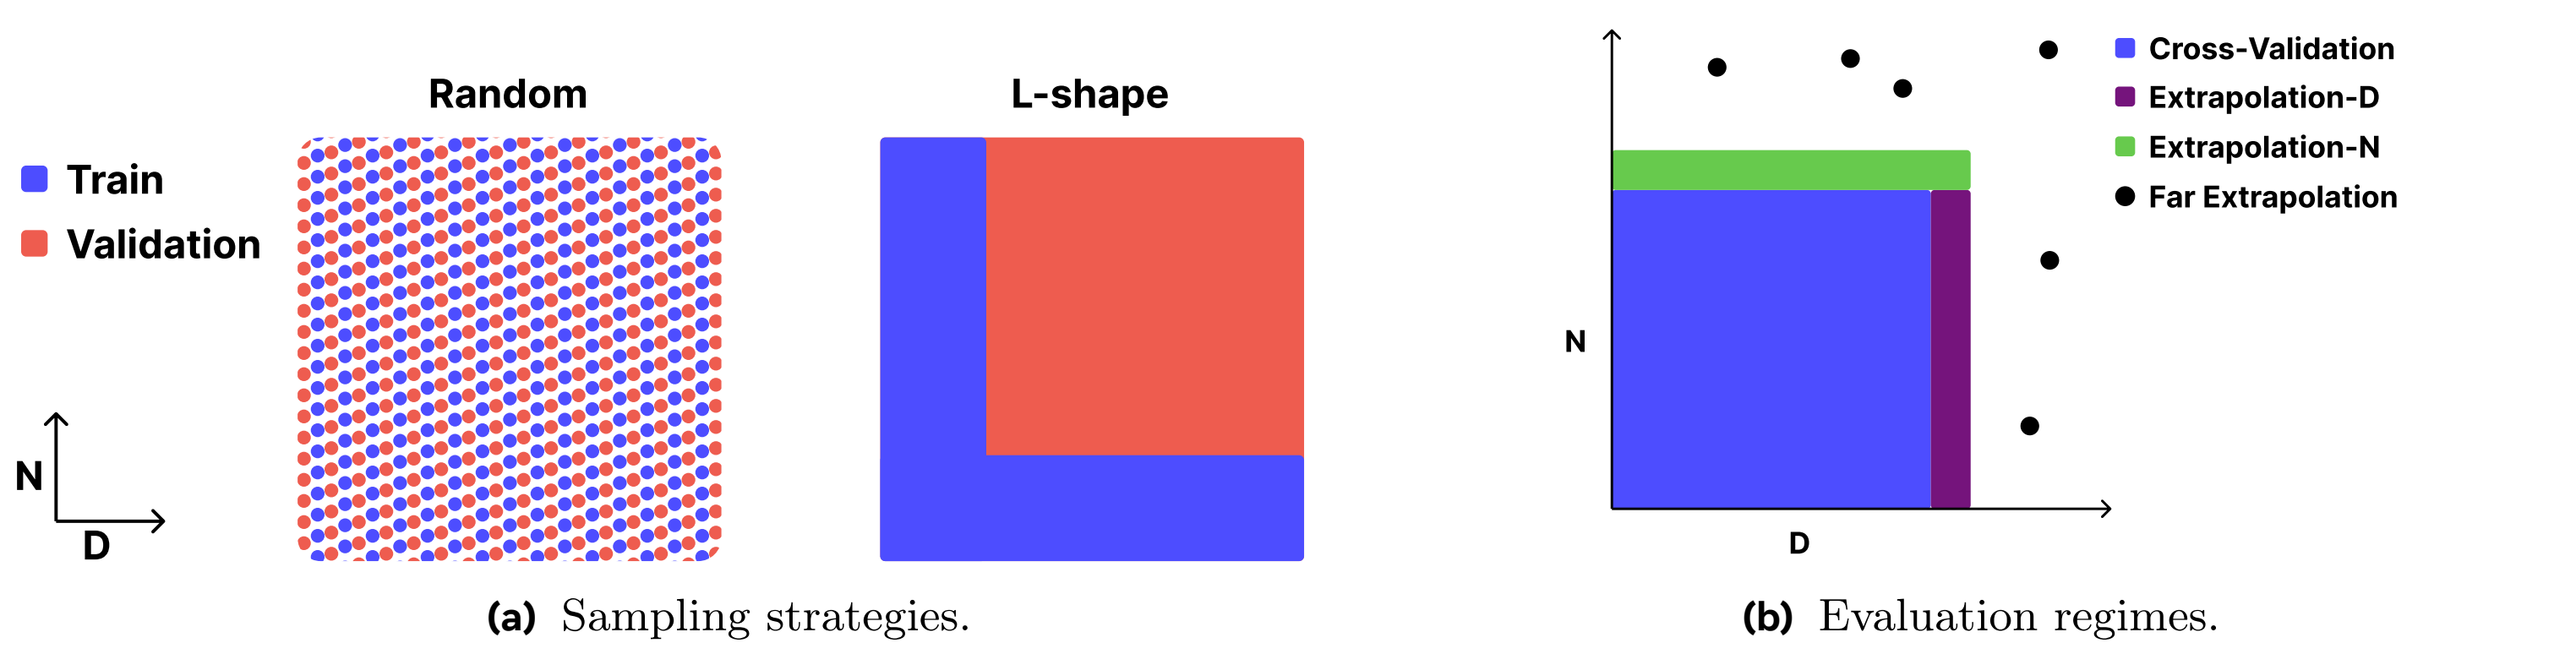
更实用的是,更贴合真实曲面的函数形式还能大幅压缩采样成本。在 Skaling 论文的测试中,仅在“小 $D$ 扫多档 $N$ + 小 $N$ 扫多档 $D$”的 L-shape 稀疏布局(见图 8)只需消耗完整网格 $1/5$–$1/10$ 的算力;Chinchilla 形式在 L-shape 上外推到大 $(N,D)$ 对角区时误差崩塌,而 Skaling 依然能保持稳健预测。
8.2 Loss 曲线与退火 Scaling Law
如果不仅想预测退火终点的单点 loss,还想预测训练全过程的动态轨迹,Tissue et al., 2024 提出了一个将任意学习率调度函数映射为步数 $s$ 上 loss 的动力学校准公式:
\[\hat L(s) = L_0 + A \cdot S_1(s)^{-\alpha} - C \cdot S_2(s)\]其中 $S_1(s)=\sum_{i\leq s}\eta_i$ 是截至步数 $s$ 的累计学习率面积(刻画主推进量),$S_2(s)$ 则是带指数遗忘核的累计学习率下降量(刻画退火带来的谷底收敛增益)。这一形式不仅能把单条轨迹上的几十个中间评估点全部利用起来,还能直接预测 cosine、WSD 以及 continued training 中二次 warmup 后的完整 loss 曲线(原文 §4.7)。
8.3 拟合协议
很多团队以为拿到实验点后跑一遍 scipy.optimize.curve_fit 就万事大吉,但 Besiroglu et al., 2024 对 Chinchilla 的复现以及 (Mis)Fitting (Li et al., 2025) 的综述都敲响了警钟:非线性幂律拟合对数值实现细节极其敏感,优化器初值、损失函数变换或异常点权重的微小改动,就足以让外推的 $(N_{opt}, D_{opt})$ 差出几倍。为保证拟合可复现,需预先固定以下协议:
- 拟合变换与损失函数:明确是在原始空间拟合 $L$ 还是在对数空间拟合 $\log L$,不可约熵 $E$ 是作为自由参数联合拟合还是先验锁定;推荐使用 Huber loss 等稳健目标函数来抑制个别异常点的杠杆效应,并平衡不同尺寸与不同轨迹长度的样本权重。
- 多起点全局寻优:由于幂律指数与系数的乘积强共线,局部梯度法极易陷入鞍点或局部极小,需在对数参数空间内设置合理的边界约束并采用多组随机初值(multi-start L-BFGS-B)检查收敛一致性。
- 结构化 Bootstrap 与决策稳定性检验:估计置信区间时,重采样必须以独立运行(或共享前缀的整个分支簇)为单位做 block bootstrap,绝不能把同一条轨迹上的几十个相邻 checkpoint 当成独立同分布样本重采样。每次重采样拟合出一组参数后,直接算出对应的目标规模预测值与最优 $N/D$(§2.3),用最终决策量的分布宽度来衡量方案是否稳健。
8.4 拟合诊断与失效处理
拿到拟合曲线后,先不要急着向外推,按以下三步做残差体检:
- 检查二维残差图是否存在系统性弯曲:将残差 $\hat L - L$ 分别对 $\log N$、$\log D$ 和 TPP 画散点图。如果残差呈现类似图 7 左图的马鞍面或单调翘尾,说明当前函数形式存在结构性欠拟合,继续外推必然产生系统偏差。
- 剔除伪自由度膨胀:再次核对中间 checkpoint 的序列相关性是否已被降权或分块处理(例如 Delphi 仅对每条 IsoFLOP 抛物线的最优点做 bootstrap,从根源上避开了轨迹内自相关)。
- 拆解误差来源:将 holdout 上的残差与同配置多随机种子的标准差对比——若残差与种子噪声同量级,说明已达预测上限;若残差远超种子噪声且方向一致,则属于函数失配或超参偏离前沿,需回到 §5.4 检查早期截断规则或在薄弱方向补点。
8.5 MoE 拟合
MoE 模型的拟合需根据 §5.6 的实验轴严格区分变量:
- 在固定稀疏率 $S$ 与专家粒度的规模 Ladder 上,直接用单 token 激活参数量 $N_{active}$ 替换公式中的 $N$ 即可获得良好的幂律拟合(同时归档对应的 $N_{total}$)。
- 一旦实验跨越不同的总专家数或专家尺寸,就必须采用显式包含稀疏率 $S$ 与粒度项的联合函数形式(Krajewski et al., 2024;Ludziejewski et al., 2025),切勿把不同稀疏度的点混入单纯关于 $N_{active}$ 的二元公式中强行拟合。
- 将独立拟合的 dense 对照曲线与 MoE 曲线放在同一等效算力坐标系下对比,即可读出 MoE 的算力乘数随模型规模扩张是保持恒定、扩大还是收窄。
9. 下游任务预测
9.1 方法路线
从预训练规模外推下游 benchmark 准确率,目前主要有三条技术路线:
| 预测路线 | 核心建模链路 | 代表性工作 | 优势与局限 |
|---|---|---|---|
| Loss $\to$ Accuracy | 先由 $(N,D)$ 外推预训练通用 loss,再通过单调函数映射为下游得分 | Gadre et al., 2024(错误率对 perplexity 的幂律);Delphi(sigmoid 映射) | 最简单直接;但通用语料 loss 与特定专业任务之间常存在分布偏移 |
| $(N,D) \to$ Task NLL $\to$ Acc | 两阶段解耦:先对目标任务正确选项的负对数似然(NLL)做幂律外推,再拟合 NLL 到离散准确率的映射 | Bhagia et al., 2024(OLMo Task Ladder);Llama 3 §3.2.1(外推至 405B) | 绕开了通用 loss 与专项任务的分布差;但不同任务的二阶段转换噪声差异极大 |
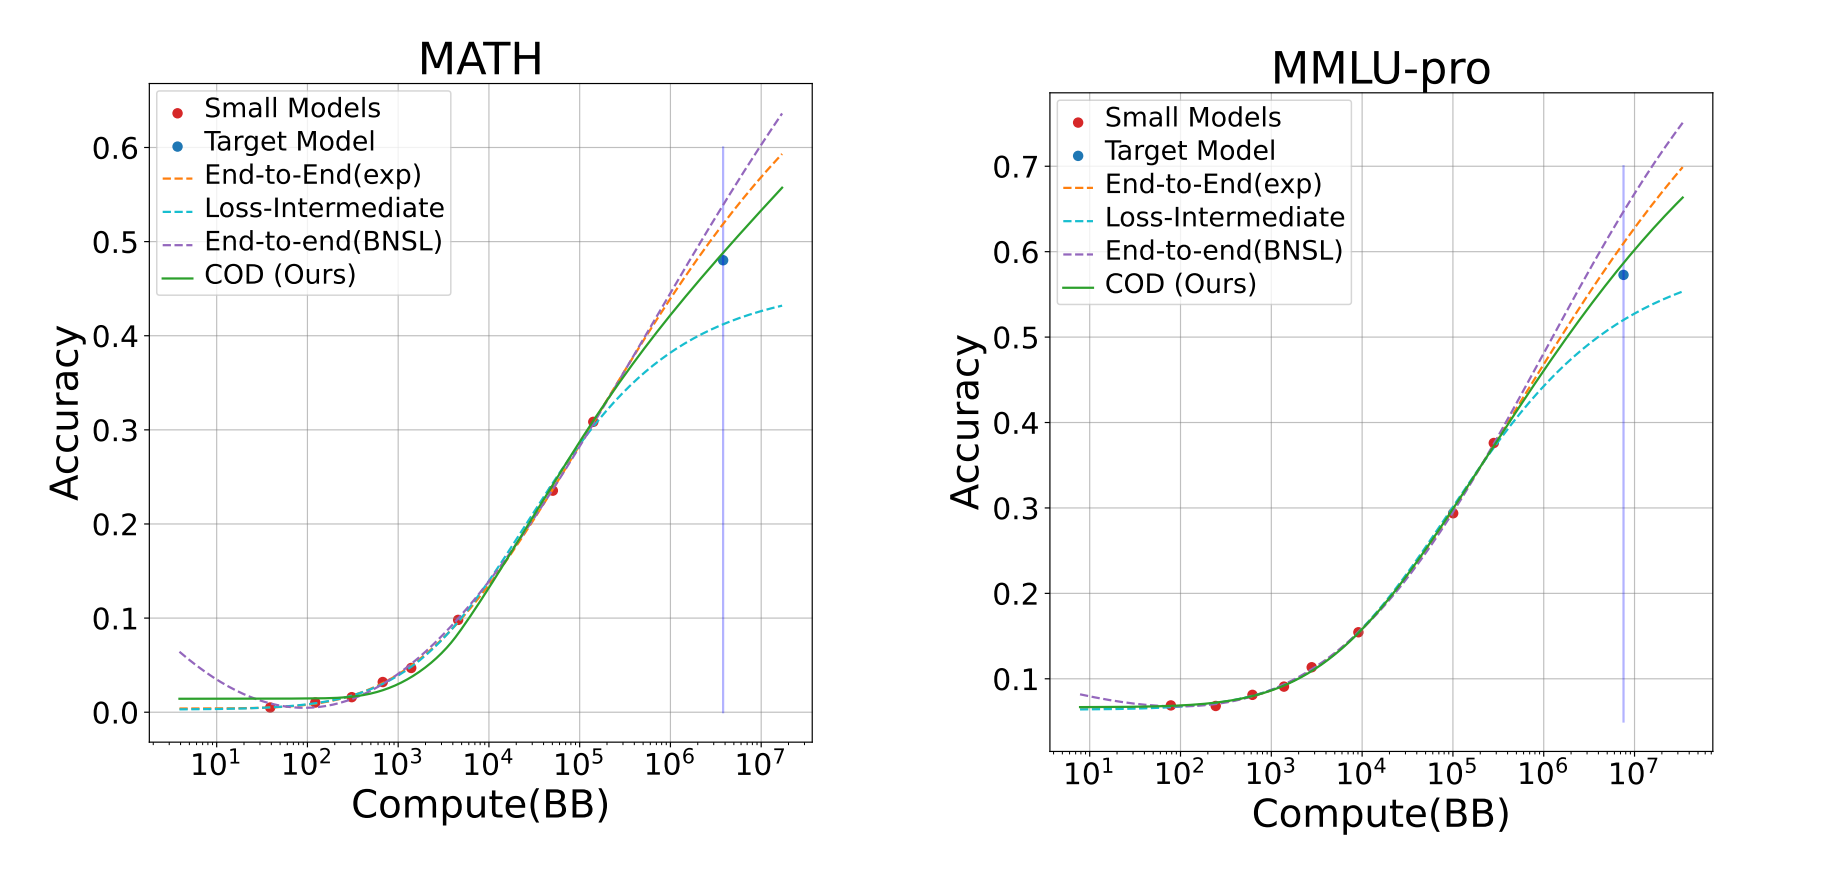
| 按难度分桶的端到端预测 | 依据小模型表现对题目做难度聚类,在可预测难度簇上直接拟合算力到准确率的曲线,再映射回全集 | COD (Xu et al., 2026, v4)(难度特征聚类);GPT-4 Technical Report(HumanEval 分桶) | 专门解决高难任务在小模型上全军覆没导致的零信号难题;依赖多次采样与聚类稳定性 |
以 Llama 3 §3.2.1 为例,第一阶段仅使用 $\le 10^{22}$ FLOPs 的 Ladder 小模型拟合正确选项归一化 NLL 对 $\log\text{FLOPs}$ 的线性关系;第二阶段则把 Ladder 模型与已有的 Llama 2 系列模型拼在一起,拟合 NLL 到 accuracy 的 sigmoid 曲线,在 ARC-Challenge 等任务上对 405B 做出了相当紧致的预测(实测略高于预测)。日常搭建时,可以先用 Delphi 的 IsoFLOP 加 sigmoid 映射跑通基线,再对重点关注的推理类任务引入两阶段或分桶方法。
9.2 COD 框架
为什么很多推理 benchmark(如 MATH)在小模型上完全没法拟合成光滑曲线?因为测试集里混杂了大量小模型得分为 0 的极难题和很快满分的简单题。COD (Xu et al., 2026, v4) 通过四个步骤把“不可预测的全集”拆解为“可预测的子集”:
- 多模型采样与难度聚类:用一组小模型对每道题做多次采样,以各模型上的平均 pass rate 向量作为该题的难度指纹,通过聚类将题库切分为不同难度等级的簇;
- 分簇拟合:对每个难度簇单独拟合带猜测下界 $g$ 的双指数曲线 $E[\mathrm{Acc}(C)] = g + (1-g) \cdot e^{-aC^{-b}-c}$;
- 筛选可靠簇并外推:剔除在小模型上尚未脱离随机猜测(全零)或已提前饱和的退化簇,仅用有清晰上升信号的中等难度簇外推至目标算力 $C$,按簇内题量加权汇总;
- 子集到全集校准:利用小模型在不同阶段的数据,拟合一条从“可外推子集得分”到“完整测试集总分”的单调映射曲线。
在 8 个主流 benchmark 上,COD v4 对 70B 模型的平均绝对预测误差仅为 1.55 个百分点(原文 Table 1)。
应用 COD 时需留意几条边界条件:
- 题库太小的评测集聚类方差大,且更换模型架构或大幅改变预训练语料分布后,题目的相对难度顺序可能洗牌,需要重新检验聚类与映射的稳定性;
- 若目标运行包含数据分布切换的 continued training 与退火阶段,小规模代理模型也必须对齐执行相同的两阶段数据与 TPP 轨迹(原文 v4 Appendix D–E);
- 跨架构外推初见成效但误差有所放大:v4 尝试直接用 dense 小模型的聚类结果去预测激活参数 32B 的 MoE 目标模型,平均绝对误差为 3.11 个百分点,最大单项误差为 8.11 个百分点(§5.3.1, Table 2);
- 对于包含开放式思维链(CoT)和多解路径的任务,虽然经验上已有较好拟合,但理论可预测性边界尚待完善(Appendix H)。
9.3 可预测性的限制
即便用上各种技巧,仍有一些下游指标难以从几百兆的小模型精确外推。Schaeffer et al., 2024 剖析了背后的统计根源:以多选题为例,模型最终选对与否不仅取决于正确选项的概率质量,还取决于最具有迷惑性的错误干扰项分走了多少概率;从连续交叉熵 loss 到最终的 argmax 离散准确率,中间每经过一层非线性截断与竞争比较,指标与对数算力之间的平滑相关性就会被削弱一层,仅靠追踪正确答案的 NLL 无法还原干扰项的动态演变。
因此,下游任务预测必须先通过 §2.2 的信号可分辨性筛选,并在大尺寸 holdout 上独立检验预测误差;对于在 holdout 上预测失准的基准,工程决策应果断退回连续的专项 BPB 或预训练 loss,避免被高方差的点预测误导。
10. 外推验证与启动决策
10.1 Holdout 验证
Holdout 实验点必须沿着真实的目标外推方向(更大的 $N$、更长的 $D$ 或更高的算力 $C$)布置,并在预算允许时设置多个递进的外推倍率阶梯(§5.2)。正如 Delphi 在 $3\times 10^{18}$–$3\times 10^{20}$ FLOPs 上拟合、一路向外设置阶梯 holdout 至 $10^{23}$ FLOPs 才成功拦截了 $33\times$ 处的性能偏离与 $333\times$ 处的训练发散(图 1),没有经过大跨度 holdout 检验的幂律公式只是对已知数据的插值平滑。
严格执行一条纪律:Holdout 只能用一次。一旦因为 holdout 预测不准而回头修改了模型配方、截断阈值或拟合函数形式,这组 holdout 点就已经降级为开发验证集,最终签发启动决策需要新的样本外证据(§2.3)。
10.2 组合验证
在分别完成架构微调、优化器切换、超参幂律标定与数据配比寻优后,切忌把各单项消融测得的百分比收益直接线性相加(Marin 后续;OLMo 3, 2025 Appendix A.2.5)。不同维度的改动经常共享同一块收益池甚至相互冲突——例如更激进的优化器可能改变模型对高重复数据的过拟合速度,新数据配比也会改变最优学习率与 weight decay。在锁定最终生产配方前,必须把所有胜出的单项改动拼成完整的候选栈,在目标 TPP 与重复率条件下做一次端到端的联合验证。
10.3 稳定性压力测试
常规小规模 Ladder 最大的盲区是训练稳定性:由于模型浅、步数短、激活值幅度小,在大规模训练中后期才会引爆的数值上溢、梯度尖峰(loss spike)和路由坍缩,在常规小模型上往往风平浪静。
为了在小尺度上提前暴露稳定性隐患,Qwen3.8-Next, 2026 提出了一种极其实用的高学习率加压测试:在中等规模模型上,故意将学习率推高到预测最优值的 $2\times$ 乃至 $4\times$,在极限优化压力下对比新旧架构或新旧优化器的崩溃边界。
当然,短程高 LR 抗压能力并不能完全等价于万亿 token 长程训练末期的数值稳定性。例如 Nemotron 3 Ultra, 2026 §2.7 报告其在训练后期遭遇了两次严重发散:第一次排查出是输出层低精度梯度下溢/上溢所致,将该层梯度切回 FP32 后恢复稳定;第二次则未能定位单一根因,最终靠提前进入退火阶段才得以化解。因此,对进入决选的配方,需全程记录各层梯度范数、激活极值与 spike 频次;MoE 模型还需额外监控单专家最大负载倍数、token 丢弃率与路由熵的长期漂移。
10.4 实现一致性验证
一个极易被忽视的工程陷阱是:跑小模型 Ladder 的代码栈与跑旗舰大模型的生产代码栈往往不是同一套物理执行路径。小模型可能跑在单机 FSDP + 标准算子上,而大模型则开启了复杂的 TP/PP/EP 混合并行、自定义融合算子、分块梯度累积、低精度通信归约与分布式优化器分片。配置文件里的参数名一模一样,不代表底层的数学运算等价。
在将 Ladder 结论迁移到生产栈之前,建议做四项对齐检查:
- 单步前反向与更新对齐:加载同一个初始化 checkpoint、喂入完全相同的单个 global batch,对比研究栈与生产栈的 forward logits、loss、各层梯度范数以及迈出第一步后的参数更新量是否在浮点容差内一致;
- 短轨迹收敛对齐:固定随机种子跑数百至数千步,确认两条训练曲线的差距始终维持在数值舍入噪声水平,没有出现系统性分离;
- 并行与归约口径对齐:改变并行切分或梯度累积步数时,逐一核对有效 global batch 大小、跨卡 loss 与梯度的归约分母(特别是含 padding 或可变长序列时)、全局梯度裁剪(grad norm clipping)的汇总顺序以及累加器的精度;
- 断点续训状态完备性:模拟故障重启,检查优化器一阶/二阶动量状态、学习率调度器步数、RNG 随机状态以及分布式数据加载器的游标是否严丝合缝地恢复,杜绝静默重复消费或漏读一个窗口的数据。
例如,DeepSeek-V3, 2024 §3.3 在 FP8 混合精度训练中对算子输入、Tensor Core 累加与优化器主权重分别设计了严格的精度与分块量化规范;Llama 3 §3.3.4 也强调了万卡集群频繁重启下数据流与状态确定性恢复的重要性。
10.5 实际效率与部署约束
算法层面的理论 FLOPs 节省,往往无法 1:1 转化为真实的训练墙钟时间(wall-clock time)缩短。Marin 后续专门区分了理论算力效率(theoretical efficiency)与实际兑现效率(realized efficiency);Nemotron 3 Ultra 同样强调不同数值精度与算子实现必须以实测吞吐为准。
因此,在利用 Scaling Law 做最终生产选型时,需要把训练与推理两侧的物理约束一并代入优化目标:
- 训练侧约束:目标集群上的实测 MFU 与每秒 token 吞吐、三维/四维并行的切分可行性、显存水位,以及周期性评测、存盘和故障重跑摊销后的有效日均训练进度;对于 MoE,专家并行的跨节点 all-to-all 通信耗时必须在目标拓扑上实测。
- 推理部署侧约束:根据线上业务的真实请求分布(输入 prefill 长度、输出 decode 长度、并发度、首字延迟 TTFT 与每 token 延迟 TPOT 限制、单机显存容量),按实际部署量化精度核算推理成本。Sardana et al., 2024 将训练成本、输入处理成本与输出生成成本拆开联合建模——把这套公式里的系数替换为你自己集群的实测单价,才能算出真正符合业务全局最优的 $(N, D)$ 配比。
10.6 中等规模试运行
当目标旗舰模型的算力超出 Ladder 最大 holdout 达两个数量级以上时(例如用 $10^{21}$ FLOPs 的 Ladder 指导 $10^{24}$–$10^{25}$ FLOPs 的训练),直接全量启动依然风险过高。更稳妥的做法是在两者之间插入一次中等规模试运行(Dress Rehearsal):
- 全程使用目标运行的生产代码栈、目标并行拓扑、目标低精度方案与最终合成的数据配比;
- 在开跑前,先用已拟合的 Scaling Law 冻结该规模下的预期 loss 轨迹与允许波动带;
- 唯有当试运行的实测曲线全程落在预测带内,且梯度、激活与路由诊断指标(§10.3)无持续异常时,才正式放行旗舰训练。
11. 专项 Ladder
11.1 分阶段 Ladder
当前主流大模型普遍采用多阶段训练管线(如通用预训练 $\to$ 高质量推理数据退火 / Mid-training $\to$ 长上下文扩展),而不同阶段的语料分布、序列长度与学习率轨迹截然不同,同一套 Scaling Law 系数无法跨阶段通用(Qwen3, 2025;OLMo 3, 2025)。对需要做定量配置决策的后续阶段,应分别搭建对应的子 Ladder:
- 主预训练 Ladder:从随机初始化出发,拟合基础的 $(N, D, \eta, B)$ 规律;
- Mid-training / 退火 Ladder:挂载对应尺寸的预训练主干 checkpoint,专门拟合新增高质量 token 预算、峰值/重热学习率与领域配比;
- 长上下文 Ladder:从 mid-training checkpoint 出发,搜索扩展后的序列长度、RoPE 基频缩放因子与微调学习率(§11.2)。
搭建分阶段 Ladder 时要注意起点条件依赖:两个总 validation loss 几乎相同的预训练 checkpoint,其内部已见数据的重复率、优化器二阶动量状态以及刚经历过的学习率高度可能大相径庭,接上同一套 mid-training 配方后的表现也会随之分化。因此,阶段交界处是否重置优化器状态、是否做二次 warmup、各阶段如何切分总 token 预算,以及各阶段局部最优方案串联后的端到端效果(§10.2),都需要通过跨起点对照实验加以确认。
11.2 长上下文 Ladder
长上下文扩展不仅改变注意力层的计算占比(§3.2),还会改变文档拼接结构。设计长上下文 Ladder 时,需同时控制长短序列混合比例、关键信息在上下文窗口中的位置分布以及跨文档 packing 的隔离掩码,并在评估长文本能力的同时严密监控短文本基础能力是否发生退化。在评测基准选择上,RULER (Hsieh et al., 2024) 证明,仅仅跑通简单的大海捞针(needle-in-a-haystack)字面检索远不足以代表真实长文本理解,评测集必须覆盖多跳追踪、上下文聚合与长程问答等多类任务。
12. 执行流程与交付物
12.1 实验记录
Scaling Law 拟合最怕“脏数据入表”。为了让几十上百次小实验在数月跨度内保持严格可比,每次运行都应自动归档完整的元数据链路:代码 commit、完整超参配置、数据分片清单与配比哈希、tokenizer 版本、评测脚本版本、初始化与数据采样种子、父 checkpoint 路径(及共享前缀步数),以及实际运行的硬件拓扑与数值精度配置。对于中途因实验设计主动关停、因学习率过高发散、因节点硬件故障中断或因代码 bug 作废的运行,应在实验表中打上明确的状态标签,既不能把发散前的瞬时 loss 混作正常终点,也不应静默删库掩盖不稳定的超参边界。
12.2 运行中偏离处理
当大规模目标训练正式启动后,Ladder 产出的预测曲线(§8.2)和各小尺寸的参考轨迹就成为了实时监控的“仪表盘”。如果实测 loss 只是偶发单点跳出预测置信带,通常源于评估集采样波动或局部数据批次起伏;但如果在连续一段训练进度窗口内系统性偏高且呈发散开口,则应按由易到难的顺序快速排查:先核对评估脚本、token 计数与配置参数是否写错,再排查数据流加载顺序、分布式归约与底层算子精度是否发生静默漂移(§10.4),最后才归结为配方本身的外推失效并启动干预。
12.3 Ladder 维护
基础设施与训练配方都在持续迭代,Scaling Ladder 也应当作为一项长期工程资产来维护:
- 黄金回归基准(Regression Suite):保留几个跨尺寸的标准配置点及其历史 loss 轨迹;每当升级深度学习框架、替换底层算子 kernel、调整并行通信库或迁移计算集群后,先重跑这几个回归点,确认 loss 偏差落在随机种子方差以内;
- 系数与配方版本绑定:每次拟合出的幂律系数都应与对应的数据集版本、模型族结构与拟合脚本绑定归档;
- 增量校准机制:当架构细节、优化器、语料版本、精度方案或词表发生演进时,先在两三个小尺寸点上检验旧幂律预测是否依然吻合,仅在偏差越界时触发局部系数重标定或全量重跑。
12.4 Checklist
实验设计阶段
- 明确本次属于哪类场景(§1.2)与哪类决策目标(§2.1),敲定配套的评价协议(§2.2)
- 确认所选评估指标在小模型上有足够分辨度;若交付后训练模型,为决选候选安排轻量级 SFT/RL 验收(§2.2)
- 在查看 holdout 前锁定验收阈值,优先以等效算力倍数衡量(§2.3)
- 厘清固定量、缩放规则与自变量,将 warmup 步数设为总训练量的固定比例(§4.1)
- 规划模型尺寸档数、跨度与多级 holdout 外推倍率(§5.2)
- 确保训练量档位覆盖目标 TPP;数据受限时显式标出 unique tokens $U$ 与重复轮数(§5.3、§7.3)
- 预留先导探路、超参搜索、多子复验与中途补点的机动预算(§5.5)
- MoE 专项:分离记录 $N_{total}$ 与 $N_{active}$,正交拆分规模、稀疏度与粒度实验轴,并配置 dense 对照点(§3.1、§5.6)
- 锁定数据版本(§7.1),确保跨数据源全局去重口径与重复轮数统计一致(§7.3)
- 数据配比寻优时以自然分布和 UniMax 为基线,同比例缩小代理数据池以对齐重复率(§7.2);多阶段训练按阶段分别寻优(§11.1)
配置与测量阶段
- 将拟合用的主干参数 $N_{\text{body}}$ 与计入 output head 及注意力的真实计算量 $C$ 分开统计(§3.1、§3.2)
- 统一主损失项、固定评估分布、token 计数与按比例触发的评估频率(§3.3)
- 锁定模型族结构属性、宽深比规则与 MoE 路由均衡策略(§4.2、§4.4)
- 全程采用目标运行的数值精度方案;跨词表对比统一换算为字节级指标 BPB(§4.5)
超参搜索阶段
- 目标 2–4 将小模型搜至网格内部的最优前沿(Fully-Tuned Frontier),目标 1 按既定配方缩放规则执行(§6.1)
- 切换优化器或改变深度缩放规则后,在小尺度重新核验超参迁移性(§6.2)
- Batch size 统一按 tokens 计量,以 $B_{opt}\propto D^{0.4\sim 0.57}$ 为先验初始化,并检验动态 batch size ramp 的影响(§6.3)
- 跨大范围 TPP 建模时,检查 weight decay 随 TPP 的偏移或按 timescale $\tau$ 联合校准(§6.4)
- 对搜参胜出的配置更换新随机种子独立复验以消除赢家偏差,且不在退火完成前过早淘汰候选(§6.7)
模型拟合阶段
- 拟合前再次核对 output head 算力、按比例 warmup 与小模型超参调优完备度(§8)
- 在验证集上对比 Skaling 与 Chinchilla 等候选形式(§8.1);多 epoch 场景纳入有效数据量衰减项(§7.3)
- 预先锁定训练初期高噪声 checkpoint 的截断阈值(§5.4)
- 采用多起点稳健回归,按独立运行或共享前缀簇做 block bootstrap,并将不确定性传播至最终决策量(§8.3)
- 检查二维残差图是否存在马鞍形或单调系统偏差,分离种子方差与模型失配误差(§8.4)
外推验证与交付阶段
- 在样本外 holdout 上按预设阈值检验外推精度,且不将 holdout 用于反向调参(§10.1)
- 涉及下游基准预测时,单独检验任务级映射或聚类外推在 holdout 上的误差(§9)
- 将所有胜出的单项改动合并后做端到端组合验证(§10.2)
- 架构或优化器变更后,通过 $2\times/4\times$ 高学习率加压测试与长程监控排查稳定性隐患(§10.3)
- 对齐研究栈与生产栈的单步更新、短轨迹收敛及断点续训状态恢复(§10.4)
- 结合目标集群实测吞吐与线上推理负载约束核算全局最优配比(§10.5)
- 外推跨度极大时,在生产栈上安排中等规模试运行(§10.6)
- 归档完整实验元数据、拟合脚本与回归基准(§12)
附录 A. 公开 Ladder 配置
A.1 公开规模配置
主流 Scaling Law 研究中采用的 Ladder 扫描规模与训练量(参数量口径依各原始文献):
| 来源 | 模型参数量范围 | 训练数据量 / 算力范围 | 参考文献 |
|---|---|---|---|
| OpenAI | 多尺寸,最大 1.5B(不含 embedding) | 22M–23B tokens | Kaplan et al., 2020 |
| DeepMind Chinchilla | 70M–16B(400+ 模型) | 5B–500B tokens | Hoffmann et al., 2022 |
| StepFun | 多尺寸(3,700+ 模型) | 全实验累计约 100T tokens | Step Law (Li et al., 2025) |
| Gadre et al. | 11M–6.9B(104 个模型) | 最高 32× Chinchilla 配比 | Gadre et al., 2024 |
| Fantastic Optimizers | 0.1B–1.2B(4 个尺寸) | 1×–8× Chinchilla 配比 | Wen et al., 2025 |
| Delphi | 按算力扫描尺寸与训练量,最大 holdout 25B | 拟合 $3\times 10^{18}$–$3\times 10^{20}$ FLOPs,holdout 至 $10^{23}$ FLOPs | Marin, 2026 |
| Llama 3 | 40M–16B | 拟合 $6\times 10^{18}$–$10^{22}$ FLOPs,外推目标 $3.8\times 10^{25}$ FLOPs | Llama 3, 2024 §3.2.1 |
部分开源基座模型的最终训练量(供对照目标生产 TPP 参考):
| 来源 | 发布模型尺寸 | 累计训练量 | 参考文献 |
|---|---|---|---|
| NVIDIA Nemotron | 15B, 340B | 8T, 9T tokens | 15B 报告;340B 报告 |
| OLMo | 1B, 7B, 13B, 32B | OLMo 1:2T–2.46T;OLMo 2:分阶段增配至最高 5T+ | OLMo, 2024;OLMo 2, 2025 |
| Llama 3 | 8B, 70B, 405B | 405B:15.6T tokens(接近算力最优);8B/70B 深度过训练 | Llama 3, 2024 §1、§3.4 |
A.2 Fantastic Optimizers Ladder
Fantastic Optimizers (Wen et al., 2025) Table 2–3 给出了一套面向优化器公平对比与超参精细搜索的 dense 基准:采用 Llama 2 架构,四个尺寸全部固定为 32 层、MHA、序列长度 4096,仅通过缩放隐藏维 hidden_dim 改变参数量。
| 尺寸 | hidden_dim | inter_dim | heads | 训练量档位 |
|---|---|---|---|---|
| 130M | 512 | 2,048 | 8 | 1×–8× Chinchilla |
| 300M | 768 | 3,072 | 12 | 同上 |
| 520M | 1,024 | 4,096 | 16 | 同上 |
| 1.2B | 1,536 | 6,144 | 24 | 同上 |
数据采用 DCLM-baseline、StarCoder V2 Data 与 ProofPile 2 混合。每个(尺寸,训练量)网格点均独立做超参搜索(例如 Table 3 中某档 AdamW 最优解为 Peak LR 8e-3、WD 0.1、warmup 2000 steps、BSZ 128 条序列即约 0.5M tokens,而到了 520M/1× 档则变为 WD 0.2、BSZ 256)。
A.3 Delphi Ladder
Delphi (Marin, 2026) 展示了一套面向端到端 loss 预测与大跨度外推的 dense 基准:基于 Qwen 3 decoder-only 架构(MLP ratio 4,序列长度 4096),后续进一步扩展至 MoE 架构(535B-A23B)。
全系固定使用 AdamH 优化器、WSD 调度(10% warmup,最后 20% 线性衰减至 0)、FP32 主参数配 BF16 计算及 FSDP 并行,语料由 Nemotron-CC、StarCoderData 与 ProofPile 2 组成。实验在 $3\times 10^{18}$–$3\times 10^{20}$ FLOPs 间做 IsoFLOP 扫描并提取 7 个最优点拟合幂律,超参直接由预设缩放公式驱动而非逐点手搜,随后在 $10^{21}$–$10^{23}$ FLOPs(最高 25B 模型,对应 $3\times$–$333\times$ 外推)的阶梯 holdout 上验证预测精度。
A.4 选择建议
- 侧重搜参规律与算法横向对比:参考 Fantastic Optimizers 的 $(N \times \text{TPP})$ 规则网格,把预算花在将每个小尺寸网格点搜到 Fully-Tuned Frontier。
- 侧重端到端算力分配与大规模 loss 预测:参考 Delphi 的 IsoFLOP 扫描布局与预设超参公式,用阶梯式 holdout 严控外推发散风险。
- 扩展至生产目标模型:上述两套公开配置均为 dense 起点;若目标模型为 MoE,需按 §5.6 拆解实验轴,并确保小模型的 GQA 分组与宽深比演进规则与目标模型一致(§4.2)。
参考文献
按主题分类汇总,每条文献后附正文中引用的对应小节。
Scaling Law 基础、函数形式与拟合
- Scaling Laws for Neural Language Models — Kaplan et al., OpenAI, 2020. arXiv:2001.08361
跨越 7 个数量级的经验幂律与非 embedding 参数口径(§3.1、§4.3) - Training Compute-Optimal Large Language Models (Chinchilla) — Hoffmann et al., DeepMind, 2022. arXiv:2203.15556
IsoFLOP 扫描方法、$N$ 与 $D$ 等比例缩放及加性幂律方程(§3.1、§5.3、§8.1) - Language models scale reliably with over-training and on downstream tasks — Gadre et al., 2024. arXiv:2403.08540
最高 32× Chinchilla 过训练区间的幂律外推与下游错误率映射(§5.3、§9.1) - Skaling: Chinchilla’s Exponents Meet Kaplan’s Coupling — Videau et al., FAIR at Meta, 2026. arXiv:2608.07222
引入外耦合指数 $k$ 消除四角马鞍形残差,验证 L-shape 稀疏采样(§8.1) - Predictable Scale: Part II, Farseer: A Refined Scaling Law in Large Language Models — Li et al., StepFun & Fudan, NeurIPS 2025. arXiv:2506.10972
九参数耦合形式与排除 embedding 的外推消融实验(§3.1、§8.1) - Scaling Law with Learning Rate Annealing — Tissue et al., 2024. arXiv:2408.11029
基于累计学习率面积与退火核的全轨迹 loss 曲线建模(§6.5、§8.2) - A Hitchhiker’s Guide to Scaling Law Estimation — Choshen et al., MIT/IBM, ICML 2025. arXiv:2410.11840
早期 checkpoint 截断、尺寸跨度与随机种子噪声的系统实证(§2.3、§5.2、§5.4、§5.5) - Resolving Discrepancies in Compute-Optimal Scaling of Language Models — Porian et al., NeurIPS 2024. arXiv:2406.19146
揭示 output head 算力、固定 warmup 与超参欠调对幂律指数的扭曲(§3.1、§4.1、§8) - Chinchilla Scaling: A Replication Attempt — Besiroglu et al., Epoch AI, 2024. arXiv:2404.10102
复现 Chinchilla 参数拟合,分析优化设置与置信区间敏感性(§8.3) - (Mis)Fitting: A Survey of Scaling Laws — Li et al., 2025. arXiv:2502.18969
综述拟合目标与数值细节缺失对结论可复现性的影响(§8.3) - Beyond Chinchilla-Optimal: Accounting for Inference in Language Model Scaling Laws — Sardana et al., 2024. arXiv:2401.00448
计入推理成本的算力最优偏移及高达 10,000 TPP 的过训练实验(§5.3、§10.5) - Gemstones: A Model Suite for Multi-Faceted Scaling Laws — McLeish et al., 2025. arXiv:2502.06857
宽深比对下游表现的影响及采样点选择对资源分配结论的敏感性(§2.3、§4.3) - Scaling Laws with Vocabulary: Larger Models Deserve Larger Vocabularies — Tao et al., NeurIPS 2024. arXiv:2407.13623
证明最优词表大小随训练算力幂律增长(§4.5) - Scaling Laws for Precision — Kumar et al., 2024. arXiv:2411.04330
训练数值精度与后训练量化的联合 scaling law(§4.5)
超参 Scaling Law 与优化器
- DeepSeek LLM: Scaling Open-Source Language Models with Longtermism — DeepSeek, 2024. arXiv:2401.02954
基于算力 $C$ 的超参幂律及语料质量对最优 $N/D$ 分配的影响(§6.3、§7.1) - Predictable Scale: Part I, Step Law — Optimal Hyperparameter Scaling Law in Large Language Model Pre-training — Li et al., StepFun, 2025. arXiv:2503.04715v3
3,700+ 模型标定的 $\eta_{opt}(N,D)$ 与 $B_{opt}(D)$ 二元超参公式(§6.1、§6.3) - Power Lines: Scaling Laws for Weight Decay and Batch Size in LLM Pre-training — Bergsma et al., Cerebras, 2025. arXiv:2505.13738
$B_{opt}\propto D^{0.4}$、$B_{crit}\propto D_{min}^{0.5}$ 双曲线及基于 EMA timescale $\tau$ 的超参耦合(§6.2、§6.3、§6.4) - Scaling Optimal LR Across Token Horizons — Bjorck et al., Microsoft, 2024. arXiv:2409.19913
固定模型尺寸与 BSZ 时峰值学习率随训练长度的幂律衰减(§6.3) - Tensor Programs V: Tuning Large Neural Networks via Zero-Shot Hyperparameter Transfer ($\mu$-Transfer) — Yang et al., Microsoft, 2022. arXiv:2203.03466
$\mu$P 参数化下的跨宽度零样本学习率迁移(§6.2) - Tensor Programs VI: Feature Learning in Infinite-Depth Neural Networks — Yang et al., 2023. arXiv:2310.02244
单层残差块的 Depth-$\mu$P 与多层残差块无限深度参数化的理论局限(§6.2) - Depthwise Hyperparameter Transfer in Residual Networks: Dynamics and Scaling Limit — Bordelon et al., 2023. arXiv:2309.16620
残差分支 $1/\sqrt{\text{depth}}$ 缩放在 ResNet 与 ViT 上的跨深度超参迁移(§6.2) - Muon is Scalable for LLM Training — Liu et al., Moonshot AI, 2025. arXiv:2502.16982
对齐更新 RMS 并引入 weight decay,使 Muon 直接复用 AdamW 超参(§6.2) - Fantastic Pretraining Optimizers and Where to Find Them — Wen et al., Stanford, 2025. arXiv:2509.02046
优化器公平搜参基准、加速比随尺寸衰减及退火期排名翻转(§5.3、§6.8、附录 A.2) - Weight Decay Improves Language Model Plasticity — Han et al., 2026. arXiv:2602.11137
最优 WD 随 TPP 增大而下降及较大 WD 对后训练可塑性的保护(§6.4) - Small-Scale Experiments: Are We There Yet? — Lourie et al., NYU & Meta, 2026. arXiv:2608.11859
小模型超参高敏感性、Fully-Tuned Frontier 及拟合/验证/测试三段尺寸划分(§5.4、§6.1) - How to Allocate Your Tokens? Scaling Laws with Training Steps and Batch Size — Schaipp, Inria, 2026. arXiv:2607.01487
5% 算力损耗内约 $4\times$ 宽度的近优 batch size 区间(§6.3) - On Over-fitting in Model Selection and Subsequent Selection Bias in Performance Evaluation — Cawley & Talbot, JMLR 2010. JMLR 11
有限样本多次试验择优引入的选择偏差分析(§6.7)
MoE
- Scaling Laws for Fine-Grained Mixture of Experts — Krajewski et al., 2024. arXiv:2402.07871
将专家粒度作为独立缩放维度的 MoE scaling law(§4.4、§5.6、§8.5) - Parameters vs FLOPs: Scaling Laws for Optimal Sparsity for Mixture-of-Experts Language Models — Abnar et al., Apple, 2025. arXiv:2501.12370
固定算力与固定总参数下的最优稀疏度规律及下游迁移表现(§4.4) - Joint MoE Scaling Laws: Mixture of Experts Can Be Memory Efficient — Ludziejewski et al., 2025. arXiv:2502.05172
显存约束下联合建模专家数、激活参数与训练量(§4.4、§8.5)
数据构建、配比与重复
- Scaling Data-Constrained Language Models — Muennighoff et al., 2023. arXiv:2305.16264
多 epoch 重复训练的指数衰减有效数据量公式(§7.3) - To Repeat or Not To Repeat: Insights from Scaling LLM under Token-Crisis — Xue et al., 2023. arXiv:2305.13230
重复过拟合随参数量 $N$ 的恶化规律及 dropout 的缓解作用(§7.3) - Prescriptive Scaling Laws for Data Constrained Training — Lovelace et al., 2026. arXiv:2605.01640
参数量、unique tokens 与重复轮数三者耦合下的过拟合与算力分配(§7.3) - Larger Datasets Can Be Repeated More: A Theoretical Analysis of Multi-Epoch Scaling in Linear Regression — Yan et al., 2025. arXiv:2511.13421
最优重复轮数随数据集规模对数增长的理论分析与 LLM 实验(§7.3) - UniMax: Fairer and More Effective Language Sampling for Large-Scale Multilingual Pretraining — Chung et al., ICLR 2023. arXiv:2304.09151
限制单桶最大重复轮数的配比基线算法(§7.2) - Olmix: A Framework for Data Mixing Throughout LM Development — Chen et al., Allen Institute, ICLR 2026. arXiv:2602.12237
配比代理尺寸、分任务 log-linear 回归、重复上限约束及增量 mixture reuse(§7.2) - Scaling Laws for Mixture Pretraining Under Data Constraints — Sedova et al., Apple, 2026. arXiv:2605.12715
稀缺领域与通用语料混合训练下的高重复耐受度与配比外推(§7.3) - Decouple Searching from Training: Scaling Data Mixing via Model Merging for Large Language Model Pre-training (DeMix) — Li et al., 2026. arXiv:2602.00747
用单域组件模型加权合并替代重训小代理的配比评估方法(§7.2) - Nemotron-CC: Transforming Common Crawl into a Refined Long-Horizon Pretraining Dataset — Su et al., NVIDIA, 2024. arXiv:2412.02595
大规模清洗与合成改写语料,跨源去重中的主要重叠来源分析(§7.3)
LR Schedule 与训练收尾
- Understanding Warmup-Stable-Decay Learning Rates: A River Valley Loss Landscape Perspective — Wen et al., 2024. arXiv:2410.05192
损失曲面河谷几何下对 WSD 恒定与退火阶段的动力学解释(§6.5) - Scaling and Transferability of Annealing Strategies in Large Language Model Training — Wang et al., 2025. arXiv:2512.13705
退火比例与退火曲线的跨规模迁移规律(§6.5) - Model Merging in Pre-training of Large Language Models — ByteDance Seed, 2025. arXiv:2505.12082
WSD 恒定阶段 checkpoint 权重平均(PMA)对退火终点性能的近似(§6.9) - Model Soups: Averaging Weights of Multiple Fine-tuned Models — Wortsman et al., 2022. arXiv:2203.05482
同起点多分支独立训练后的权重平均(§6.9) - Stop Wasting My Time! Saving Days of ImageNet and BERT Training with Latest Weight Averaging (LAWA) — Kaddour, 2022. arXiv:2209.14981
单条训练轨迹末端的滑动窗口权重平均(§6.9) - Early Weight Averaging meets High Learning Rates for LLM Pre-training — Sanyal et al., COLM 2024. arXiv:2306.03241
高学习率预训练过程中的早期滑动权重平均(§6.9)
下游任务预测与评估
- Unveiling Downstream Performance Scaling of LLMs: A Clustering-Based Perspective (COD) — Xu et al., ICLR 2026, v4(2026-03-09). arXiv:2502.17262v4
基于题目难度聚类的四步下游准确率预测框架(§9.1、§9.2) - GPT-4 Technical Report — OpenAI, 2023. arXiv:2303.08774
按小模型通过率对 HumanEval 难度分桶并外推目标表现(§9.1) - Establishing Task Scaling Laws via Compute-Efficient Model Ladders (OLMo Task Ladder) — Bhagia et al., Allen Institute, 2024. arXiv:2412.04403
$(N,D) \to \text{Task NLL} \to \text{Accuracy}$ 的两阶段下游预测框架(§9.1) - Why Has Predicting Downstream Capabilities of Frontier AI Models with Scale Remained Elusive? — Schaeffer et al., 2024. arXiv:2406.04391
分析干扰项概率分布与非线性截断导致下游离散准确率难以预测的机理(§9.3) - RULER: What’s the Real Context Size of Your Long-Context Language Models? — Hsieh et al., NVIDIA, 2024. arXiv:2404.06654
涵盖多跳追踪与信息聚合的真实有效上下文长度评测基准(§11.2)
模型技术报告与 Ladder 实例
- Delphi: An Open Scaling Suite from 3e18 to 1e23 FLOPs — Marin Team, 2026. openathena.ai/blog/delphi
IsoFLOP 扫描、预设公式超参、阶梯式 holdout 验收与最优点 bootstrap(§1.1、§2.1、§5.2、§8.4、§9.1、§10.1、附录 A.3) - The Llama 3 Herd of Models — Meta, 2024. arXiv:2407.21783
405B IsoFLOP 定型、小模型过训练、两阶段下游预测、BSZ ramp 与容错训练(§5.2、§5.3、§6.3、§9.1、§10.4) - DeepSeek-V3 Technical Report — DeepSeek, 2024. arXiv:2412.19437
无辅助损失动态偏置负载均衡、零丢包路由与 FP8 分级精度规范(§4.4、§10.4) - Nemotron-4 15B Technical Report — NVIDIA, 2024. arXiv:2402.16819
Batch size ramp-up 与训练尾声的数据切换退火(§6.3、§6.9) - Nemotron-4 340B Technical Report — NVIDIA, 2024. arXiv:2406.11704
340B 模型训练配置与 token 预算参考(附录 A.1) - OLMo: Accelerating the Science of Language Models — Groeneveld et al., Allen Institute, 2024. arXiv:2402.00838
开源预训练套件、数据与中间 checkpoint 基准(附录 A.1) - 2 OLMo 2 Furious — OLMo Team, Allen Institute, 2025. arXiv:2501.00656
两阶段课程训练、micro-annealing 数据源探针与 model souping(§6.9、§7.1) - OLMo 3 — Allen Institute, 2025. arXiv:2512.13961
BPB 代理指标、Olmix 配比迭代、质量感知上采样与后训练快速验收(§2.2、§6.4、§7.2、§7.3、§10.2、§11.1) - Qwen3 Technical Report — Qwen Team, 2025. arXiv:2505.09388
多阶段超参预测与实例级细粒度属性配比(§6.4、§7.2、§11.1) - On the Design of Qwen3.8-Next Architecture: Evaluation, Efficiency, and Training Stability — Qwen Team, 2026. arXiv:2608.30320
大模型宽平坦超参盆地、Muon 超参偏移、后训练退化检验与高 LR 加压测试(§2.2、§6.1、§6.2、§10.3) - Kimi K2: Open Agentic Intelligence — Moonshot AI, 2025. arXiv:2507.20534
固定激活规模的 MoE 稀疏度 scaling law 与知识语料多版本改写消融(§5.6、§6.4、§7.3) - Kimi K2.5: Visual Agentic Intelligence — Moonshot AI, 2026. arXiv:2602.02276
持续联合预训练中的单源最大 epoch 约束(§7.3) - Kimi K3: Open Frontier Intelligence — Moonshot AI, 2026. arXiv:2607.24653
配方升级后重做 scaling law、cosine 与 WSD 独立搜参对比及知识改写复用(§6.8、§7.1、§7.3) - Nemotron 3 Super: Open, Efficient Mixture-of-Experts Hybrid Mamba-Transformer Model for Agentic Reasoning — NVIDIA, 2026. arXiv:2604.12374
25T tokens 前 80% 多样性、后 20% 高质量的两阶段配比设计(§7.2) - Nemotron 3 Ultra: Open, Efficient Mixture-of-Experts Hybrid Mamba-Transformer Model for Agentic Reasoning — NVIDIA, 2026. arXiv:2606.15007
训练后期发散的 FP32 输出层梯度修复、提前退火与垂域合成数据消融(§7.1、§10.3、§10.5) - Marin:MoE 与训练效率后续 — Marin Team, 2026. openathena.ai/blog/pretraining-speedup
理论算力效率与实际墙钟效率的区分及多项改动的组合验证(§10.5、§10.2) - Marin 数据流程 — Marin Team, 2026. openathena.ai/blog/marin-data-pipeline-overview
跨源全局去重、代理数据池同比例缩池、非单调配比回归与跨尺度确认(§7.2、§7.3) - Phi-4 Technical Report — Microsoft, 2024. arXiv:2412.08905
高方差下游评测任务的多采样降噪处理(§2.2) - GLM-4.5: Agentic, Reasoning, and Coding (ARC) Foundation Models — Zhipu AI, 2025. arXiv:2508.06471
模型深度与注意力头配置对推理表现的影响(§4.3)
延伸阅读
以下文献与大batch训练和注意力结构相关,供扩展参考:
- Critical Batch Size Revisited: A Simple Empirical Approach to Large-Batch Language Model Training — Merrill et al., 2025. arXiv:2505.23971
- An Empirical Model of Large-Batch Training — McCandlish et al., 2018. arXiv:1812.06162
- GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints — Ainslie et al., Google, 2023. arXiv:2305.13245
- Cost-Optimal Grouped-Query Attention for Long-Context Modeling — Chen et al., 2025. arXiv:2503.09579
Enjoy Reading This Article?
Here are some more articles you might like to read next: